
Gemini Omni Flash 能生成带声音的短场景:会说话、会倾听的人物,反应,日常动作,氛围和动画,单个片段最长 10 秒(Google 的 Gemini Omni Flash 模型页面)。Google 完全支持英语,并说明其他语言尚未经过评估:可能可以使用,但效果会有差异(Google 的 Omni 开发者指南)。下面的厨房场景有巴西葡萄牙语和英语两个版本。下面所有片段都由 Bald Rhino 的智能体用 Gemini Omni Flash 1.1 制作,本页的所有时间都是在片段上实测的。
1. 怎么在 Omni 提示词里写对白?
按场景应有的样子来写:构图、每个人的位置、放在引号里的确切台词、谁先说、另一个人在听的时候做什么,以及声音是什么。写明语言。给表演一个能演出来的意图,让动作来承载停顿。下面是同一个场景,用两种语言各写了一遍(提示词按发送时的原文展示):
- A small kitchen. Warm evening light from a window.
- Medium two-shot, static camera, one continuous shot. Naturalistic drama.
- An old man of about seventy with a grey beard and a cardigan sits at the table; his daughter, about forty, dark hair in a bun, stands by the counter holding a mug.
- They speak Brazilian Portuguese.
- 0:00.1 She Você vendeu o barco, pai?
- 0:01.4 He looks down, then up at her.
- 0:03.2 He Eu não conseguia mais velejar.
- 0:05.5 She sets the mug down slowly.
- Their voices, a ticking clock, quiet room tone; no music.
- A small kitchen. Warm evening light from a window.
- Medium two-shot, static camera, one continuous shot. Naturalistic drama.
- An old man of about seventy with a grey beard and a cardigan sits at the table; his daughter, about forty, dark hair in a bun, stands by the counter holding a mug.
- 0:01.4 She You sold the boat, Dad?
- 0:02.5 He looks down, then up at her.
- 0:04.3 He I couldn't sail it anymore.
- 0:05.8 She sets the mug down slowly.
- Their voices, a ticking clock, quiet room tone; no music.
(两句台词的意思:“爸,你把船卖了?”“我再也没法驾船出海了。”)没有附加任何参考素材:两张脸和两种声音都是生成的。注意提示词没有做什么。它没有规定父亲停顿多久,而是给了他一个动作:“He looks down, then up at her”(他低下头,然后抬头看她)。在两种语言里,两句台词之间的停顿都大约是 1.8 秒。它也没有直接点名情绪:杯子被慢慢放下,就说明了一切。一个 8 秒的场景,只容得下一个问题、一个回答和一个安静的肢体反应。如果你的段落比这更满,就精简台词,或在一个戏剧性的节点把场景拆开;不要让所有人都说得飞快。
两个人对话时,要用位置和外貌把每句台词绑定到一个看得见的人身上(“他的女儿,站在台面旁”),而不只靠名字:只写名字,模型可能会猜错谁说了什么。
视觉类提示词以 “No text. No subtitles.”(“不要文字,不要字幕”)结尾。标题、标签和字幕放到剪辑里加,在那里它们准确且可编辑。这条指令针对的是画面上的文字:台词本身仍然写在提示词里。
然后去听。检查用词、发音和口音、重音位置是否错了、句尾是否仓促或被切掉、说话人是否互换,以及回答听起来是否真的在回应问题。对照声音看嘴型。转写能找出漏掉的词;只有亲耳听,才知道表演是否自然。多语言原生对白是一个需要评估的选项,而不是保证。
2. Omni 能在一个片段里做多个镜头吗?
可以:按顺序描述各个视角,以及促成每次切换的事件,Omni 就会在它们之间切换。但每个新视角都会占用观众读懂一张脸所需的时间,而且提示词里的时间决定的是顺序和侧重,而不是剪切点。同一条提示词分别发给了 Omni 和 Seedance 2.5。一起播放看看:
Omni Flash 1.1 · 1080p
Seedance 2.5 · 480p 草稿
两个模型都保持了顺序,切换点也接近要求的时间(台词意为“我们不能再这样下去了。”“那你告诉我你想要什么。”)。两者都没有让台词和特写同时开始:每个说话人都先被看到再开口,读起来很顺。在 Seedance 这一条里,第二句台词和片段同时结束,没有给反应留出停留;在 Omni 这一条里,台词之后还有一秒多的雨声。两者都没错,但只有一个给剪辑留了余地。
当一个反应必须落在精确的时刻时,把它作为单独的补充镜头来生成:倾听者恍然大悟之前和之后的样子,保持相同的视线、位置和光线,并在剪辑中把说话人已确认的音频保留在反应镜头下面。一次生成的较长对话可能过早暴露反应,或者把你要求的几个角度合并在一起;而且要求一个精确的剪切时间,也替代不了在剪辑中亲自选择。
哪个模型适合哪种场景?Omni 适合短对白、反应、日常动作、产品细节、氛围和动画。对于高难度动作、精细的画面细节或更长的多镜头连贯场景,可以对比一下 Seedance。一部片子不必所有镜头都用同一个模型:围绕需求中最难的部分、你手头的参考素材和预算来选择。
3. 怎么在两个镜头里保持同一个角色?
在每次请求中都附上同一张已确认的角色图,并准确说明它负责什么。Omni 按顺序给图片命名:<IMAGE_REF_0>、<IMAGE_REF_1>;除了在提示词里写名字,还要真正附上文件,并把这个对应关系和请求放在一起保存。场景提示词提供其余的一切:地点、光线、动作和机位。
<IMAGE_REF_0>
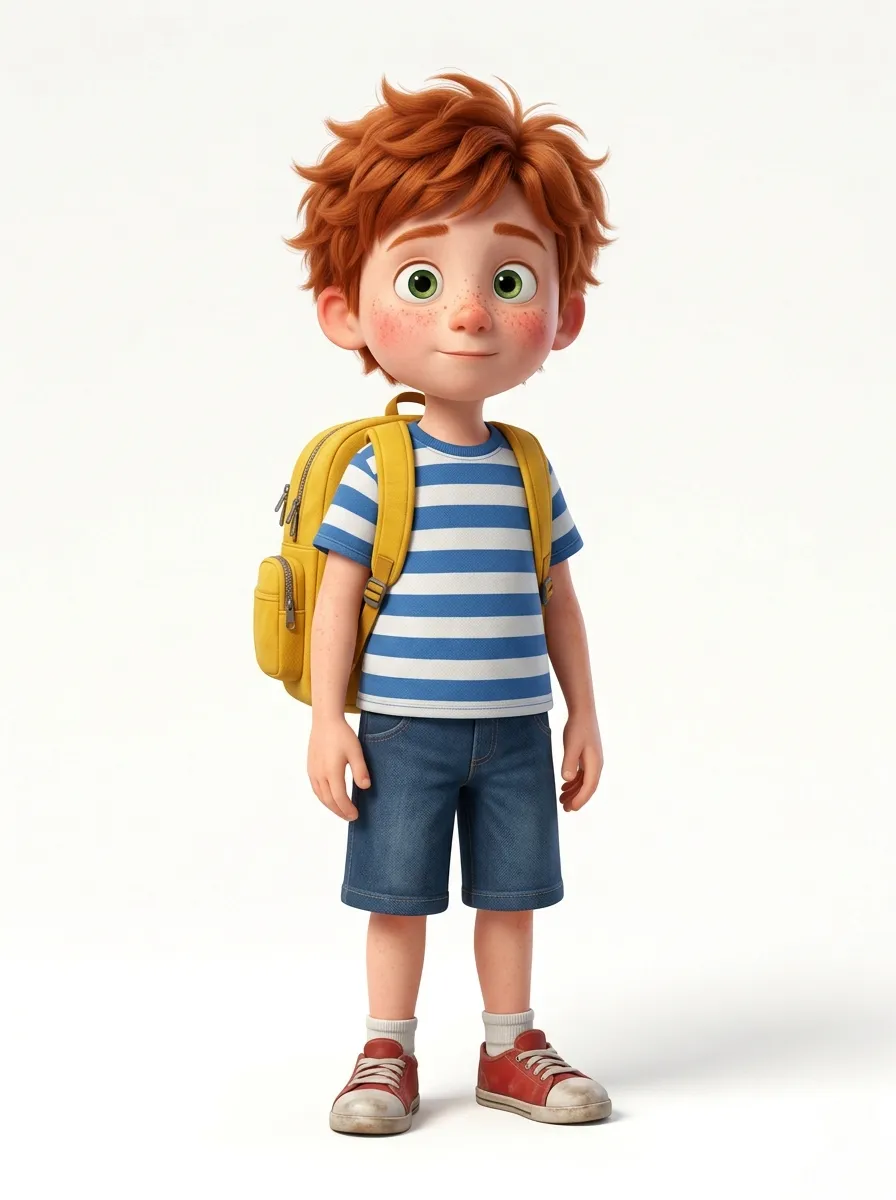
参考图保留的
- 1 他的脸
- 2 红头发
- 3 条纹 T 恤
- 4 黄色背包
远景,固定机位
-
远景,固定机位 · 这条提示词新增的 清晨明亮光线下的学校操场;他从左边跑进来,在一架秋千旁停下。远处有孩子们的声音。 -
特写,缓慢推近 · 这条提示词新增的 他抬起头,有些惊讶,然后咧嘴笑开。一阵微风。
肖像图里白色的影棚背景并没有跟着他进入操场,因为提示词给了每个画面各自的地点和动作,只要求参考图提供他的脸、头发和衣服。一张被允许把背景或姿势强加给每个场景的肖像,就是一张没有分工的参考图。
这些是分开拍的补充镜头,而不是一台连续运转的摄像机。在剪切处,对比背景、他的视线、姿态和光线。还要听:远景里有远处的孩子声,特写里只有微风。如果这个地点的声音应该不间断,就在剪辑中给两个镜头铺上同一段连续的操场环境声。如果一个固定角色的造型会随剧情变化(湿衣服、撕破的袖子),请看如何保持角色一致;如果需要补一个角色缺少的视角,可以用 Nano Banana 根据已确认的设计来生成。
4. 怎么用 Omni 让一张图片动起来?
把它作为首帧附上,描述这张图如何开始动起来,而不是描述一张新图:构图已经定了。当镜头必须抵达某个特定结果时,再加上尾帧,并描述一条合理的路径,留出到达那里的时间。同一幅匆忙的水墨城市画,两次请求(请求按发送时的原文展示):
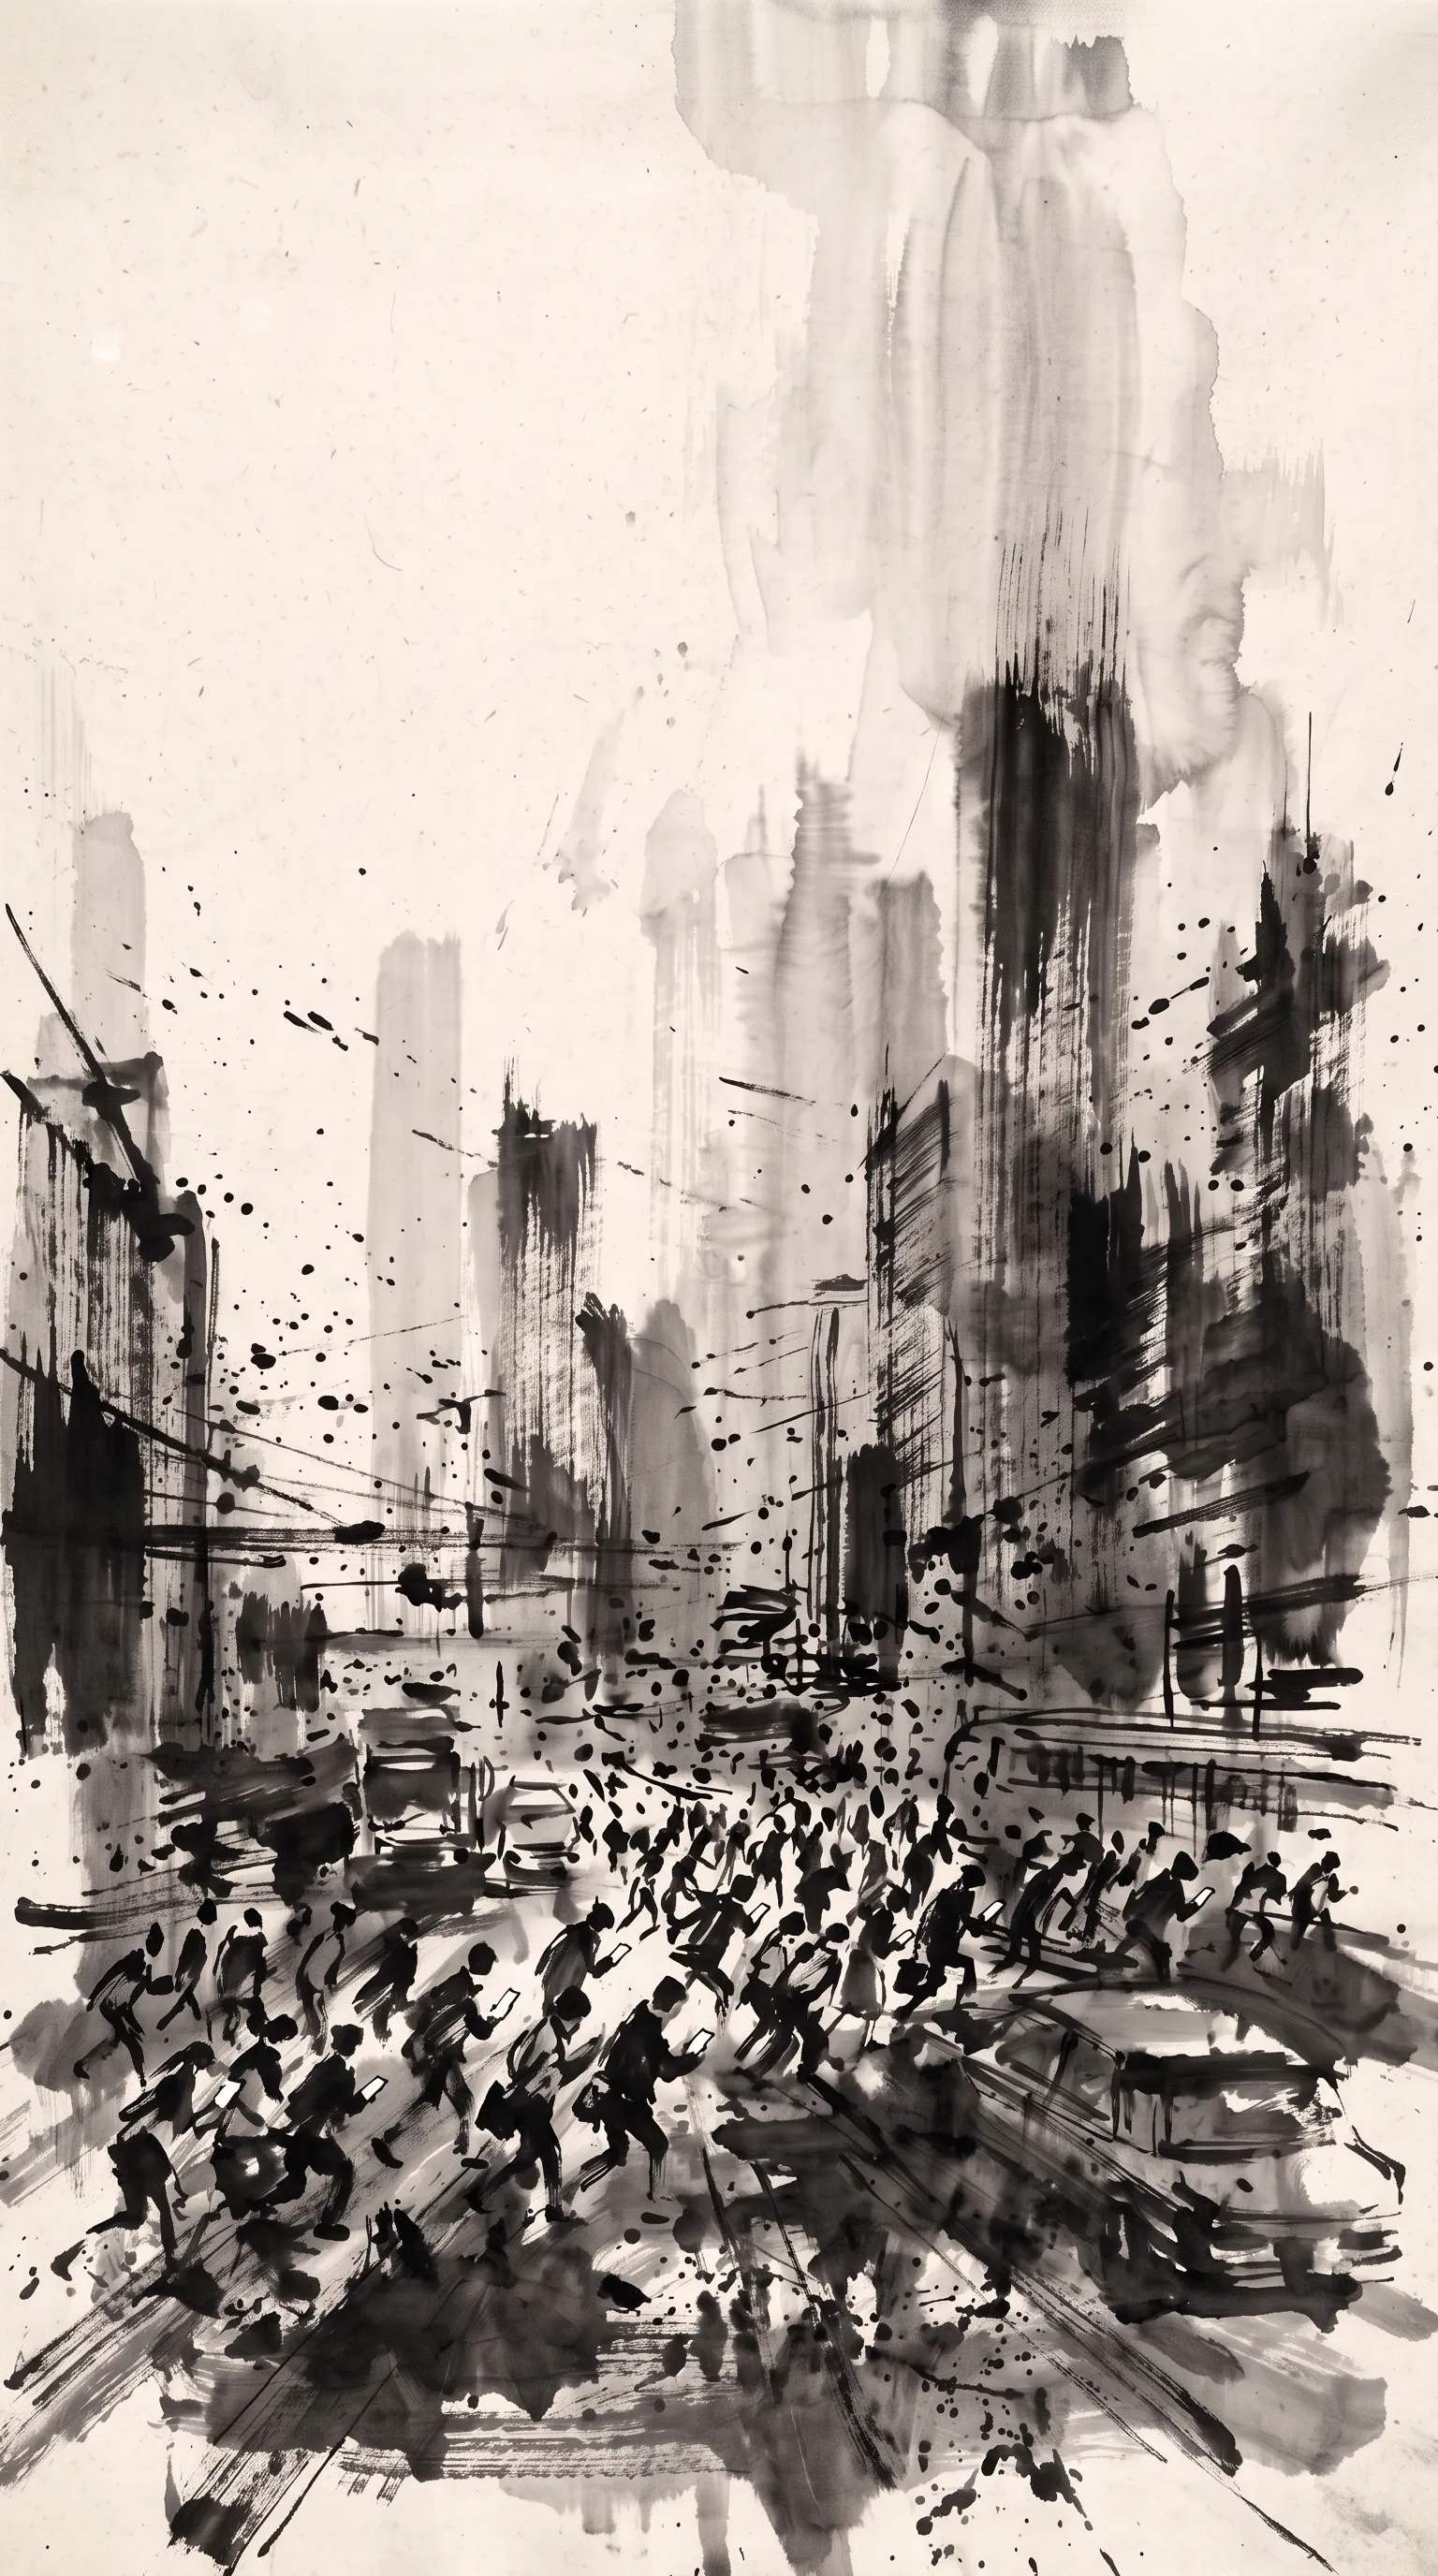
首帧
只有首帧
“The tiny ink figures surge forward in a hurried rush, ink spatter flies sideways… Fast quick push-in toward the crowd with a slight handheld jitter.”
首帧加尾帧
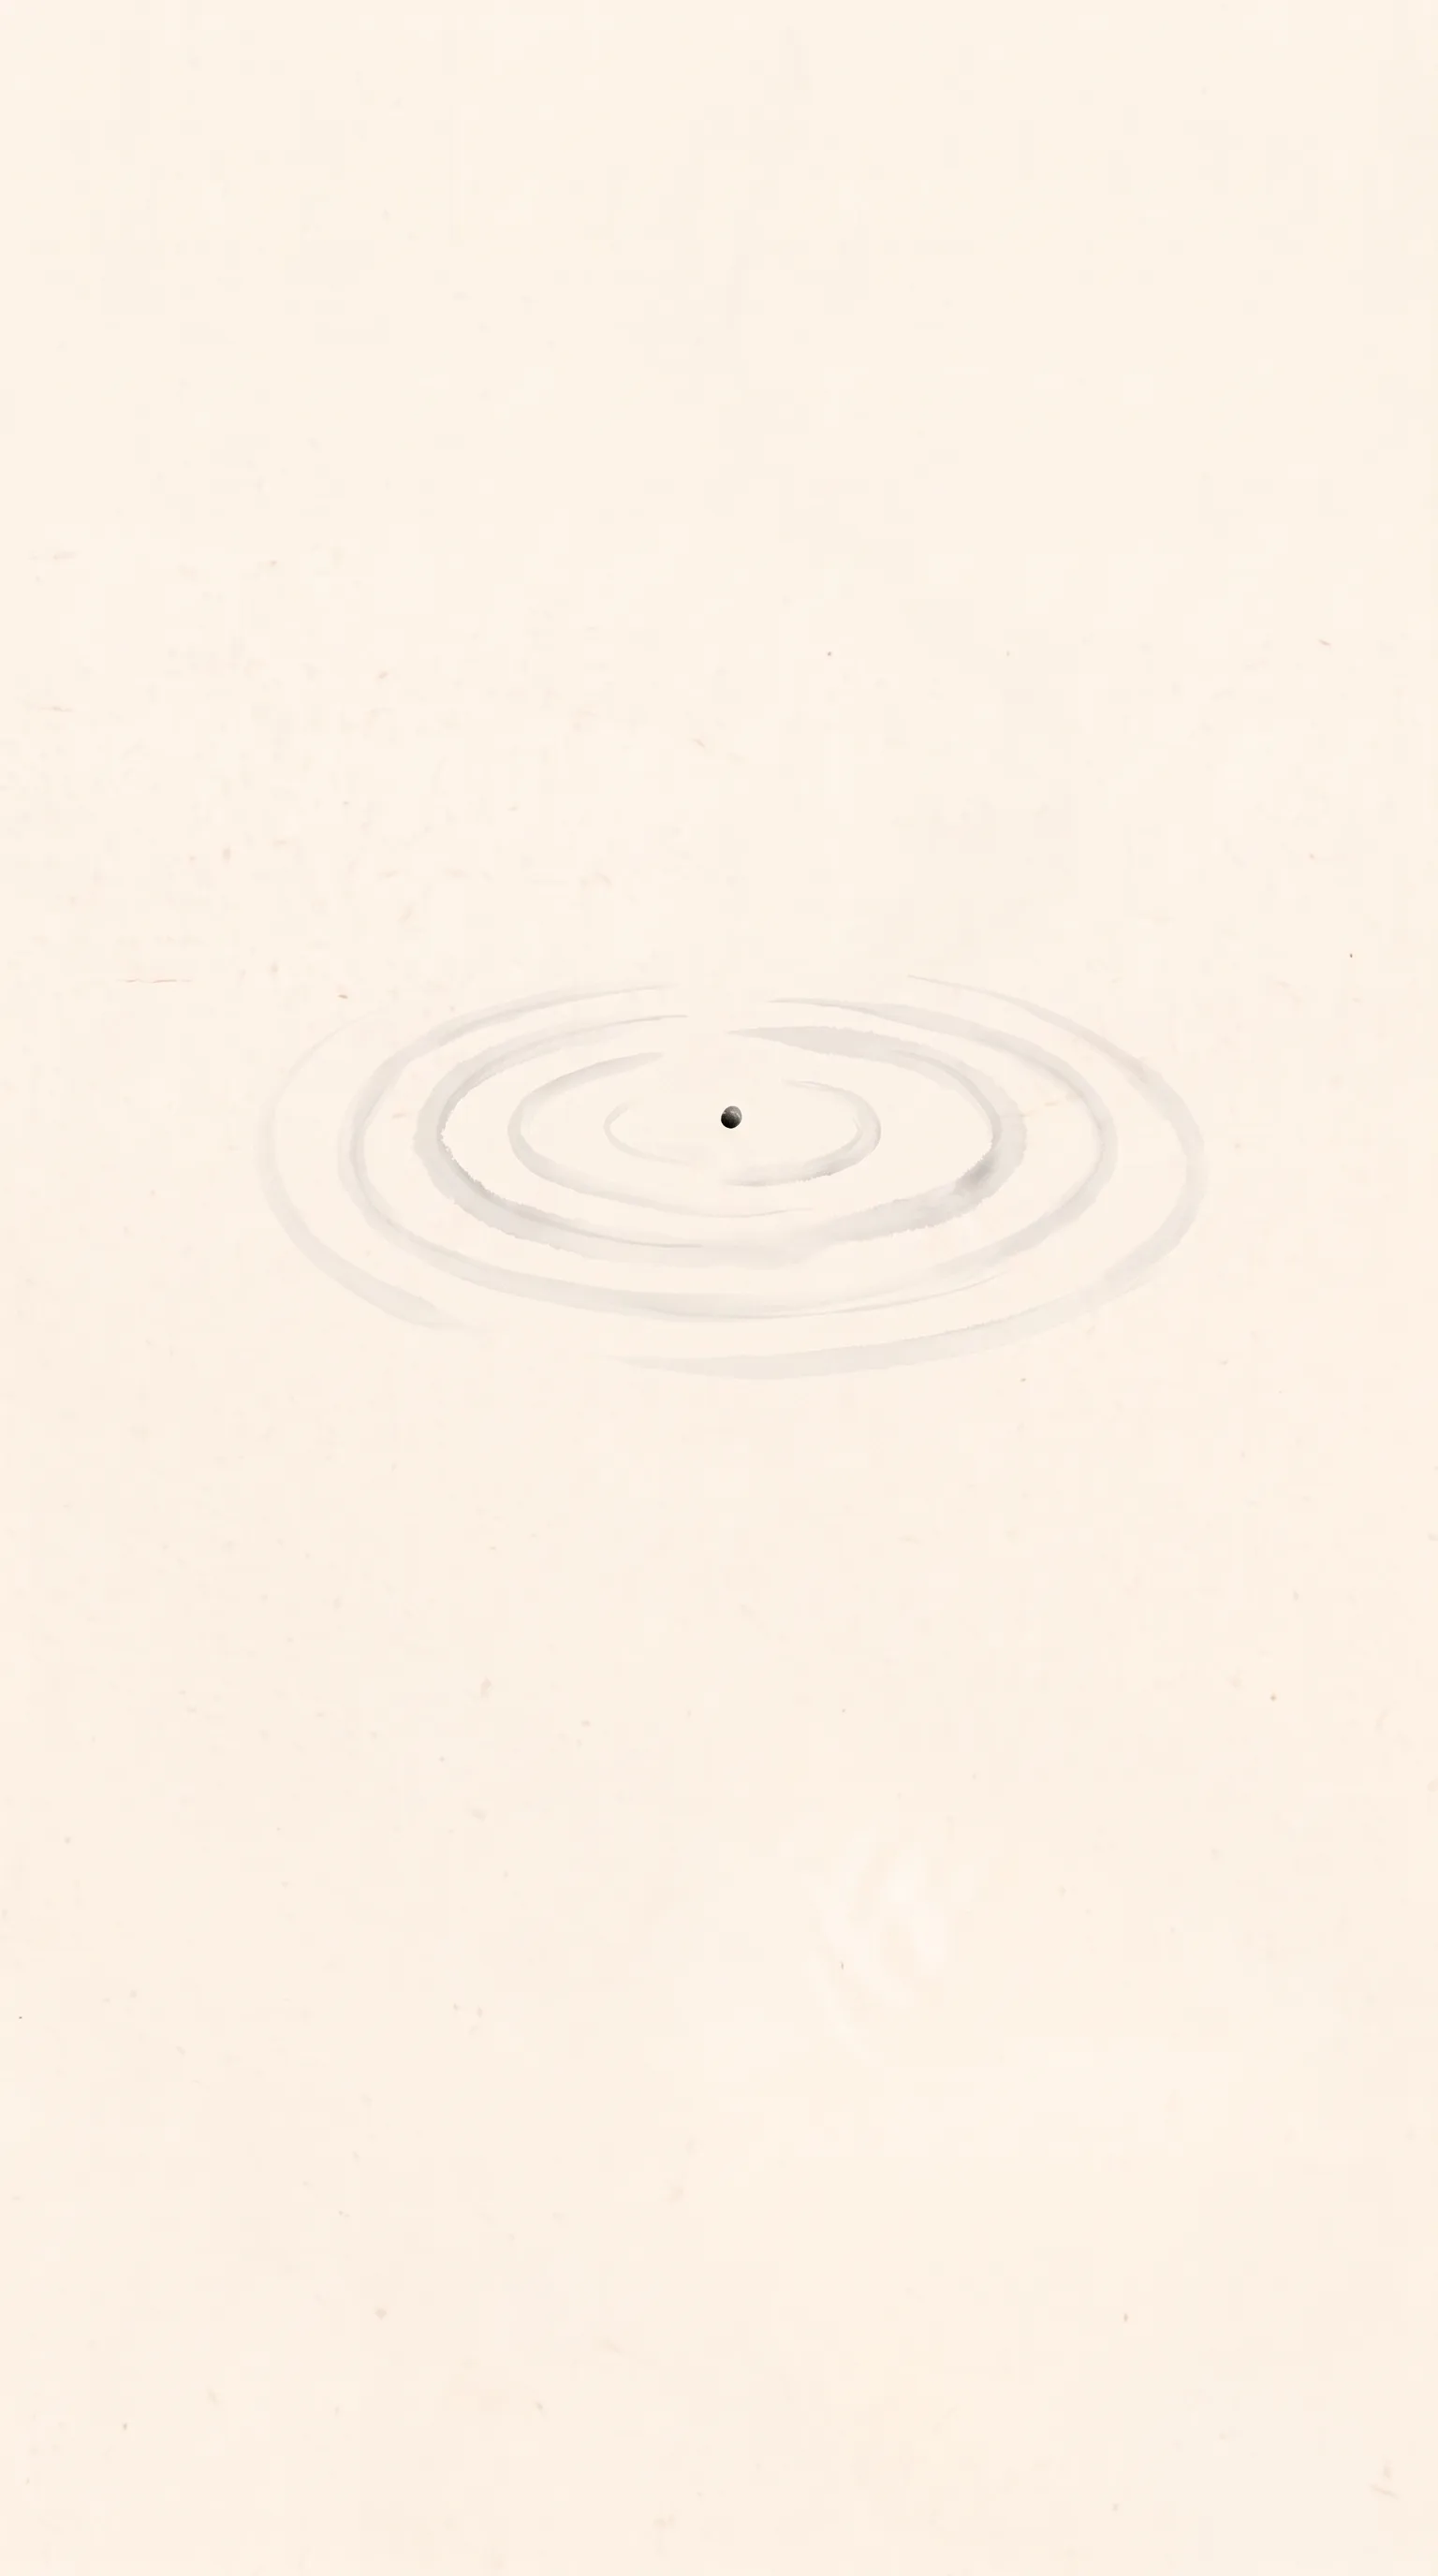
“Then everything stops, frozen. A single drop of water falls into the centre… the ink city dissolves and washes away… until only faint concentric ripple rings and one tiny ink dot remain, matching the final frame.”
第一条路径没有目的地,所以画面保留了它的世界,只是动了起来。第二条要在 6 秒内从拥挤的街道变成几乎什么都没有,所以提示词给了它一个起因(一滴水)和几个阶段(先变成浅灰,再变成干净的纸面)。第一条提示词还写明了什么不能变:“still clearly an ink painting on rice paper”(依然清楚地是一幅宣纸上的水墨画)。如果要做循环,还要检查动作和声音在首尾相接处是否连贯,而不只是结尾画面是否和开头一致。
同样的方法,用在一组水墨画上。滑动浏览;每一幅都会从它起始的那张图里苏醒过来:
-
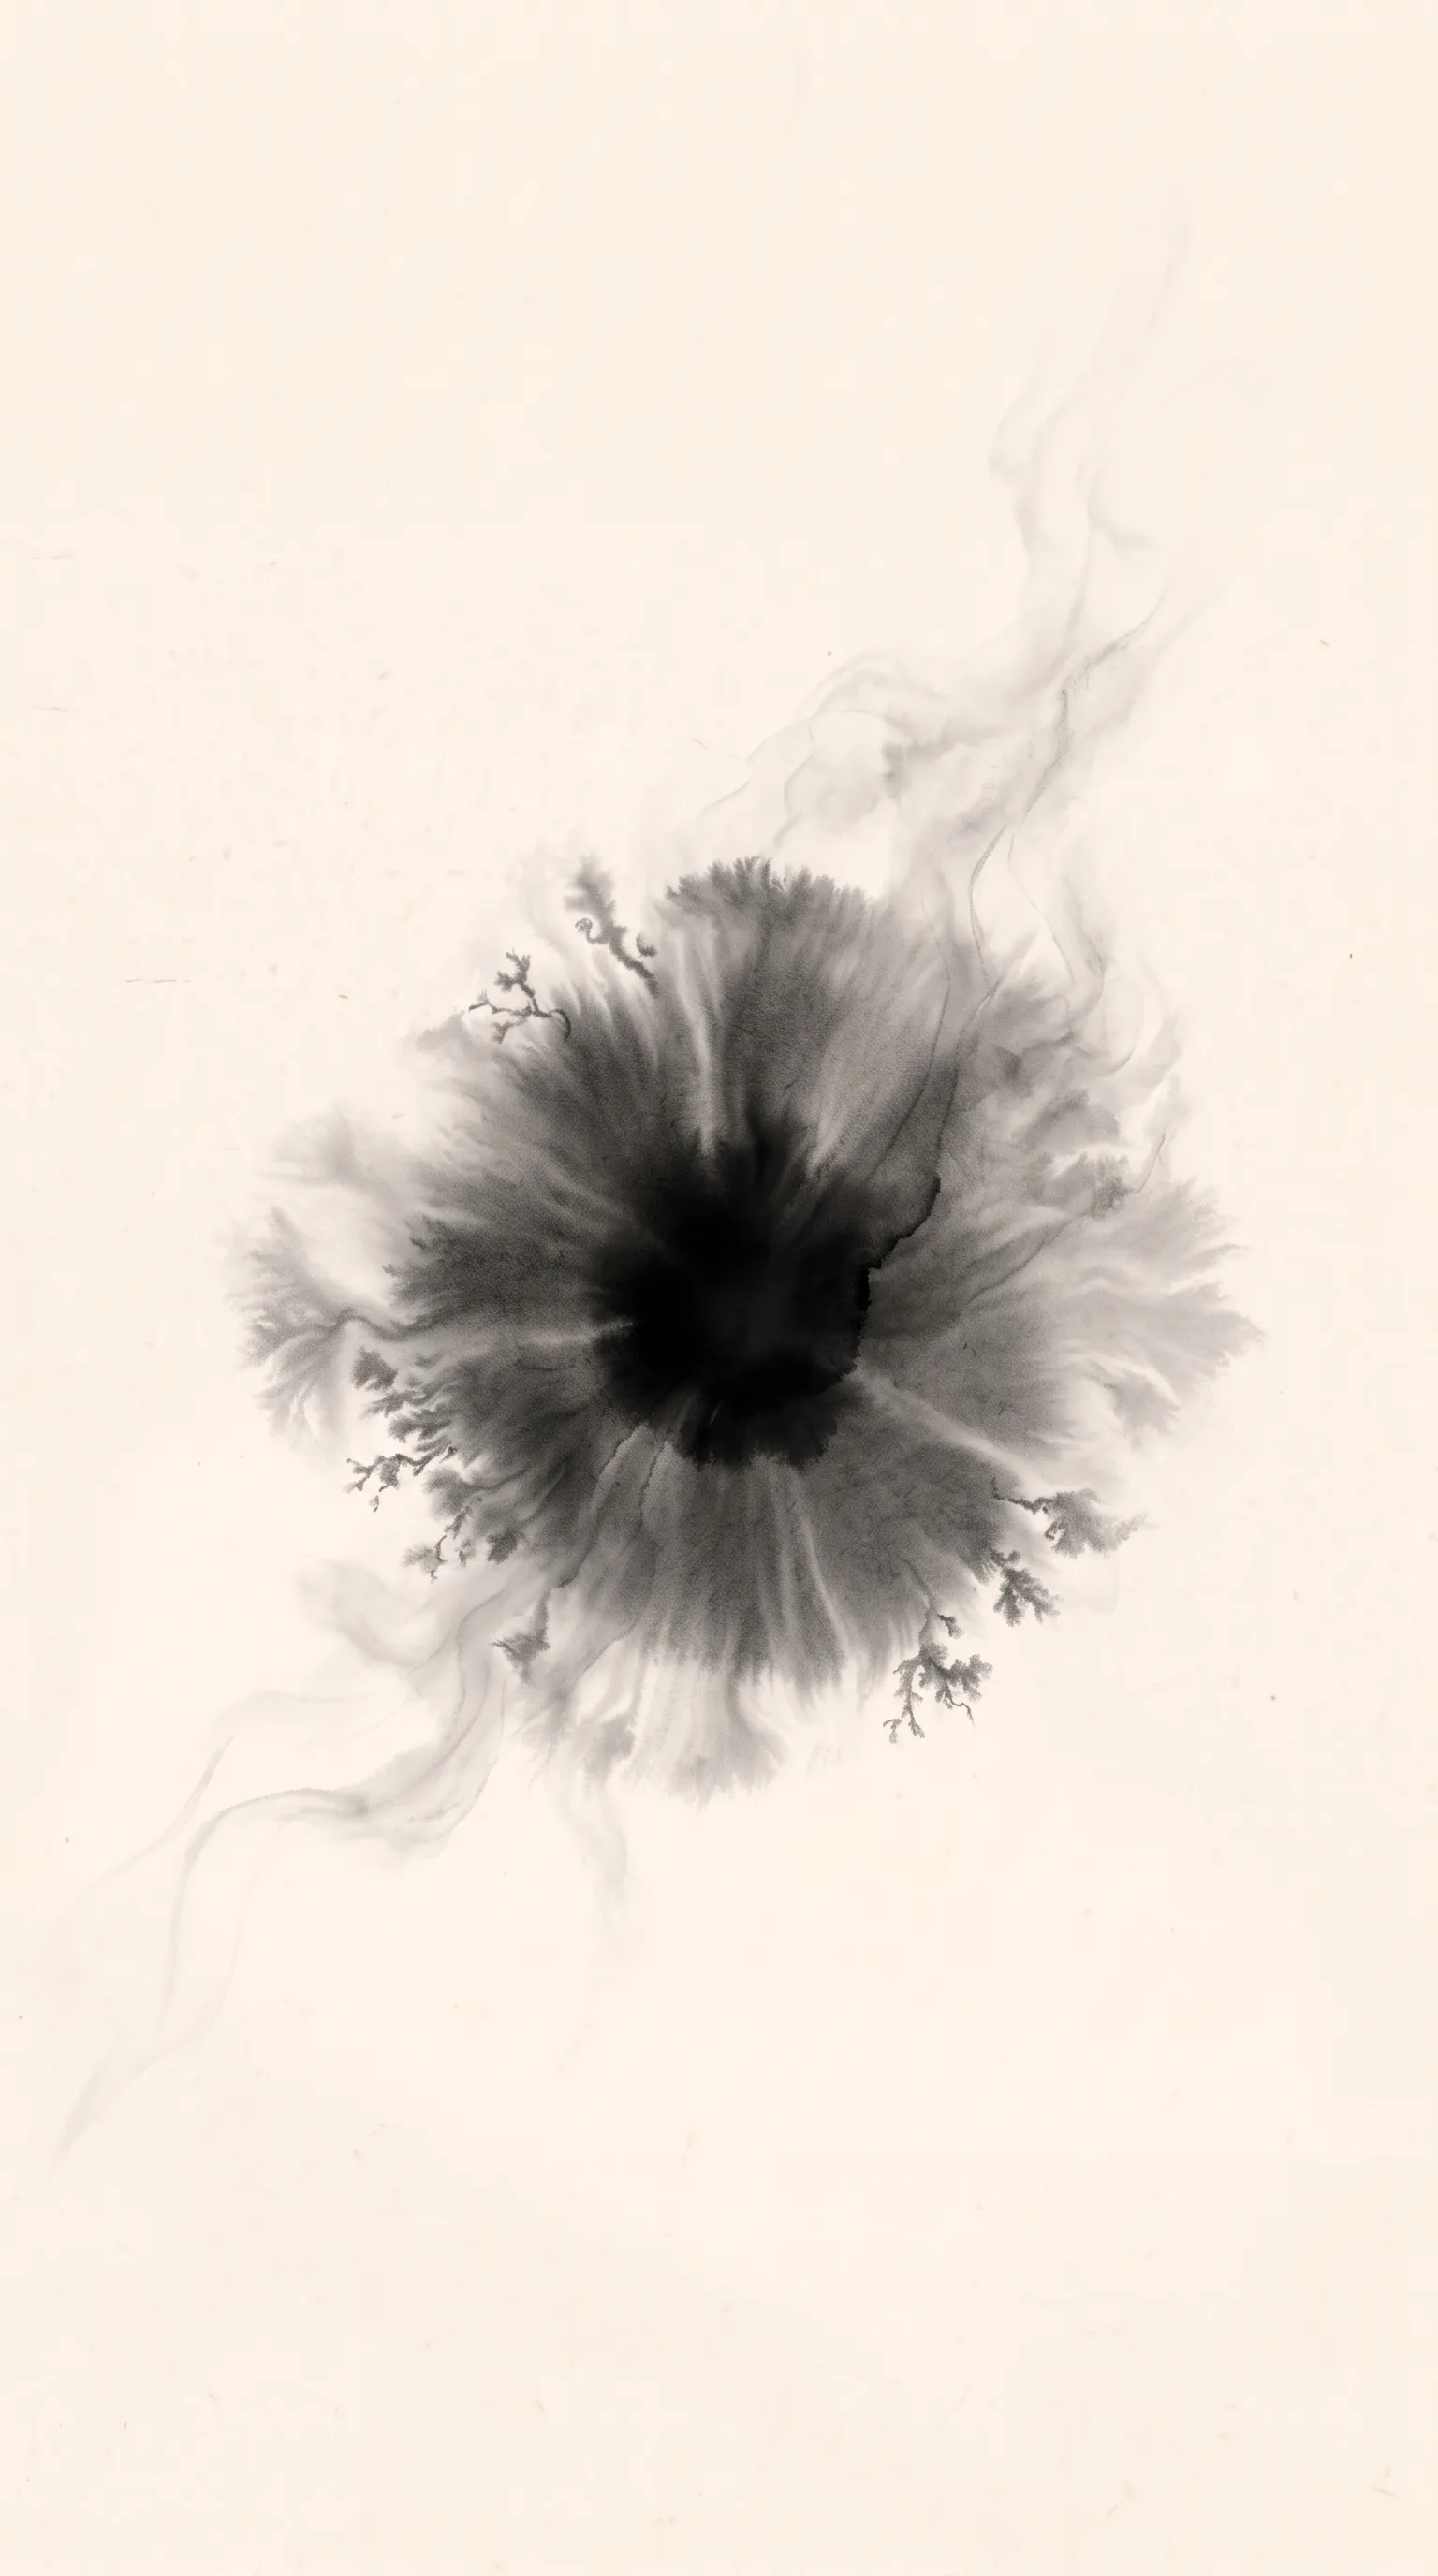
尾帧 首帧加尾帧
“A single drop of black ink falls into the centre and slowly blooms outward… until it becomes the ink bloom of the final frame.”
-
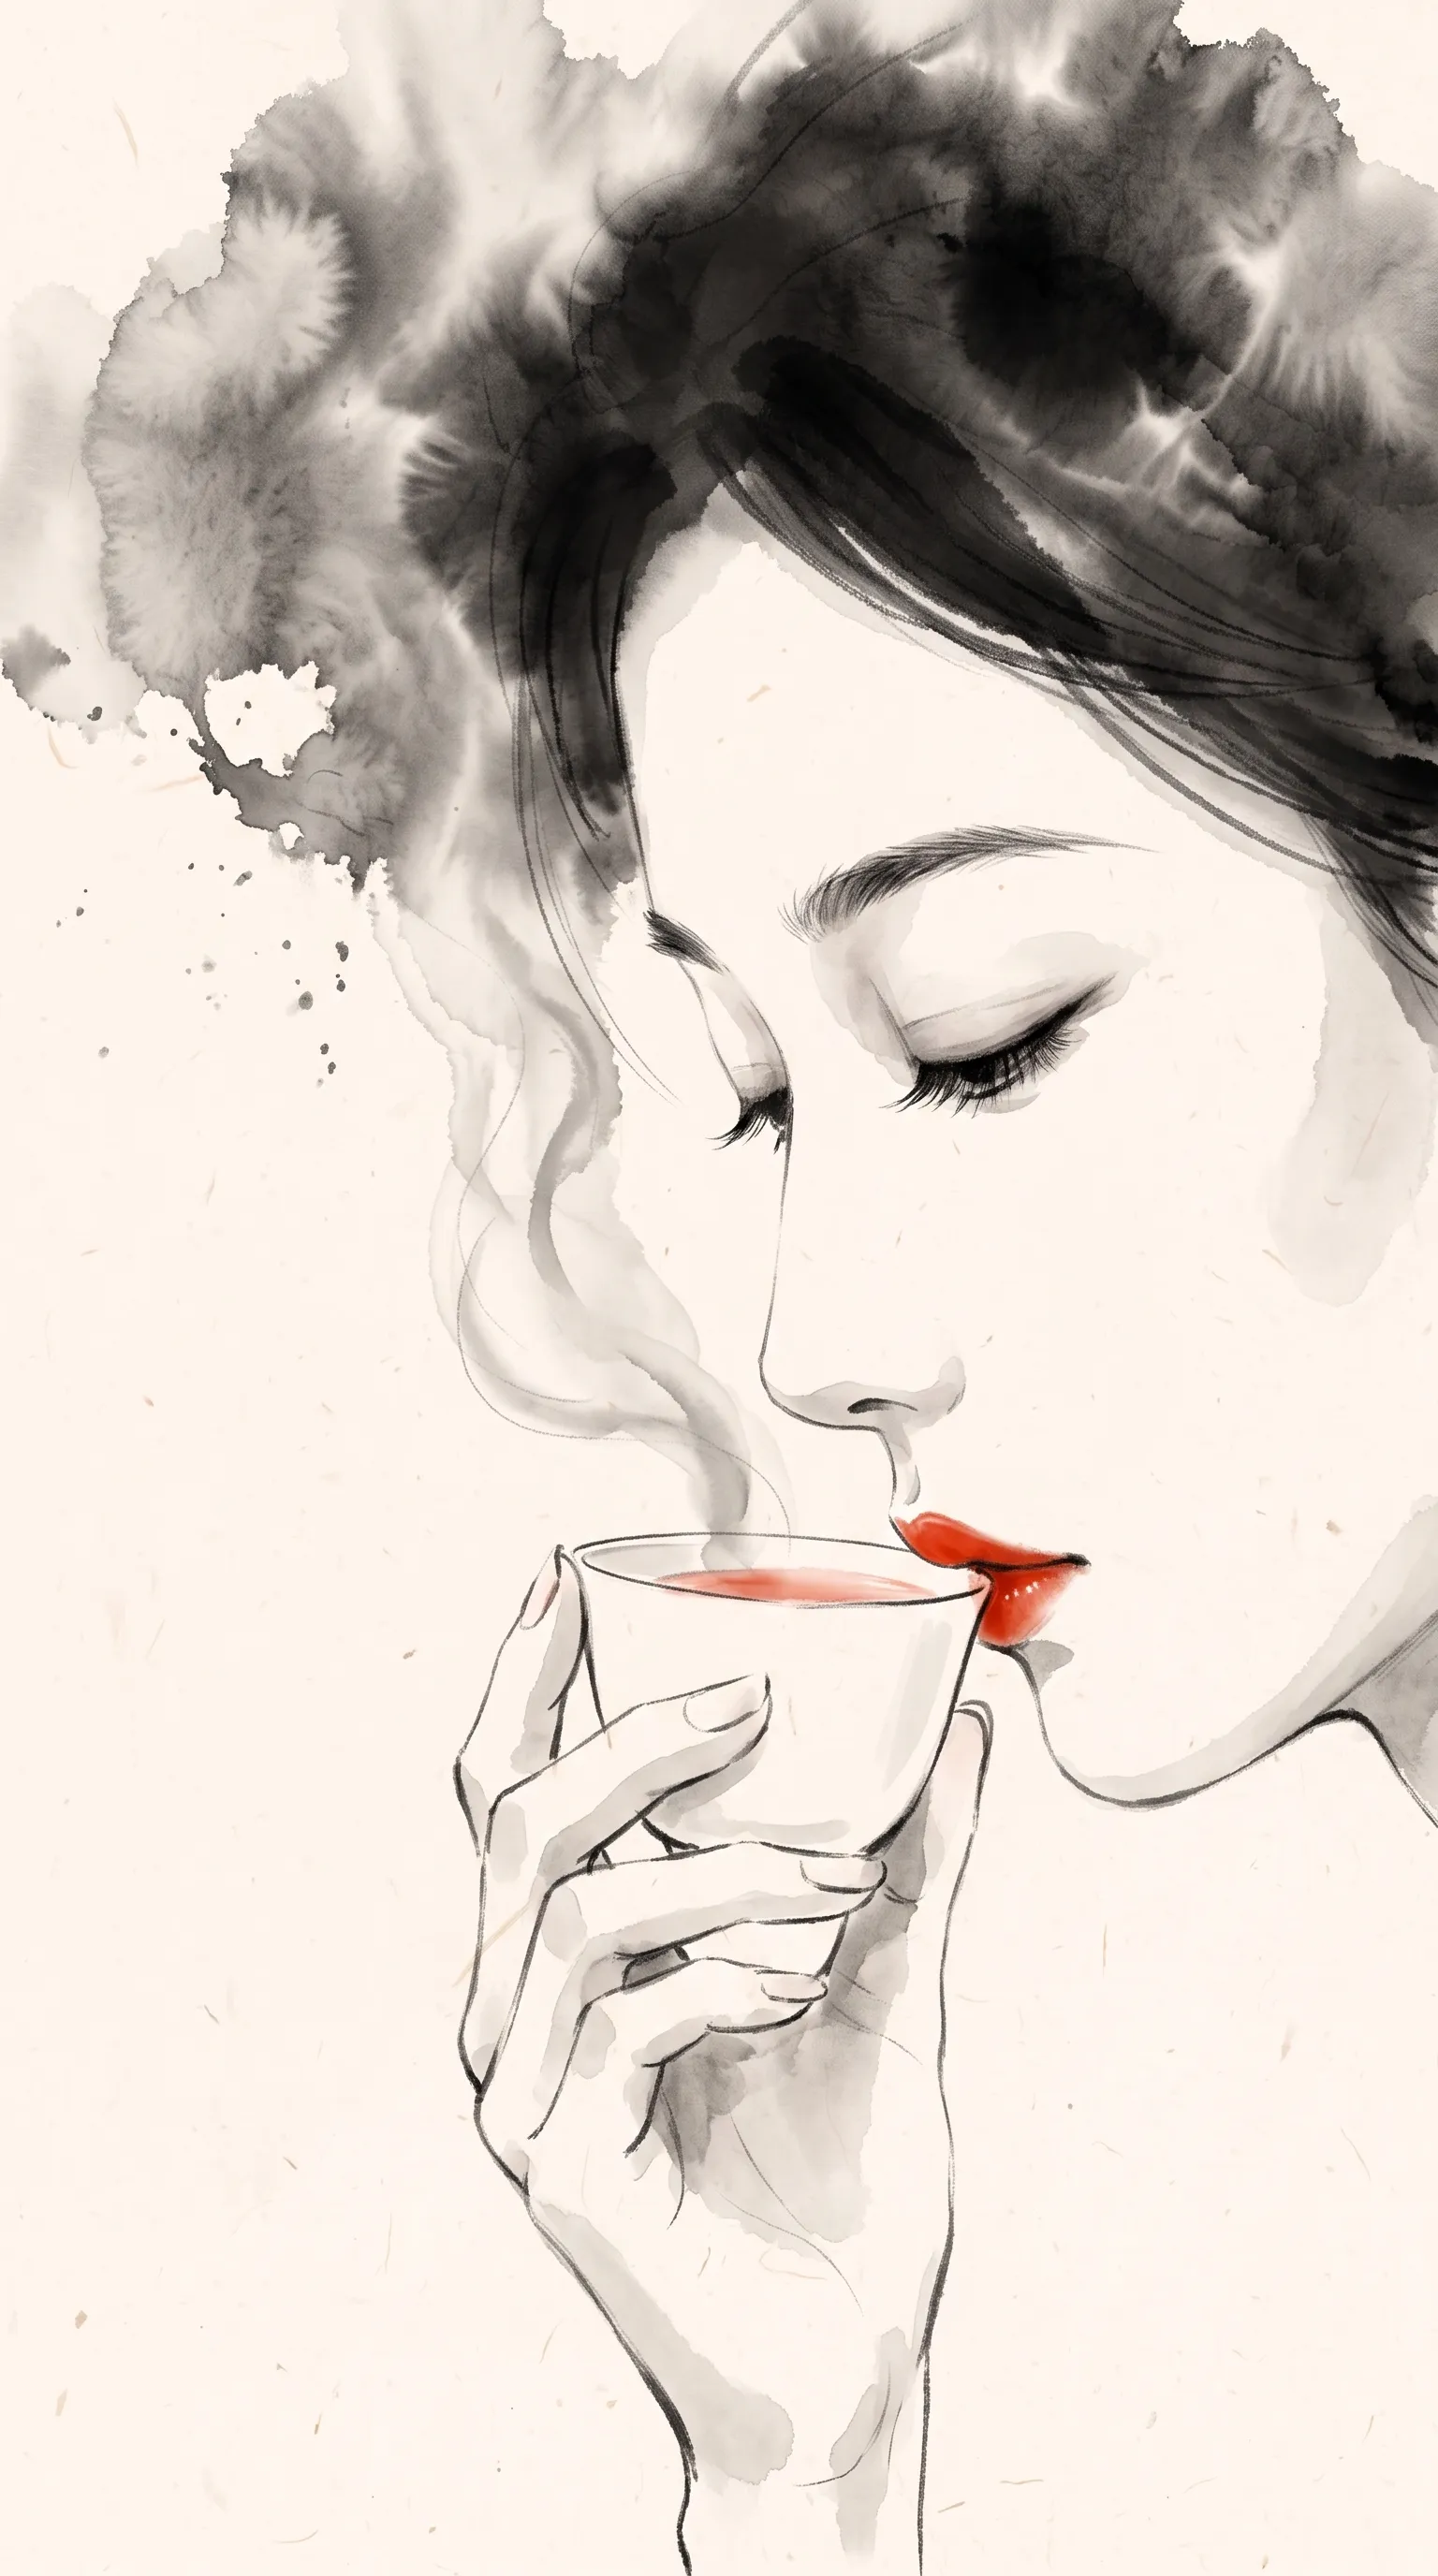
首帧
“The woman takes a slow sip of tea… the wisp of steam curls past her cheek; the ink clouds of her hair drift and bloom gently.”
-
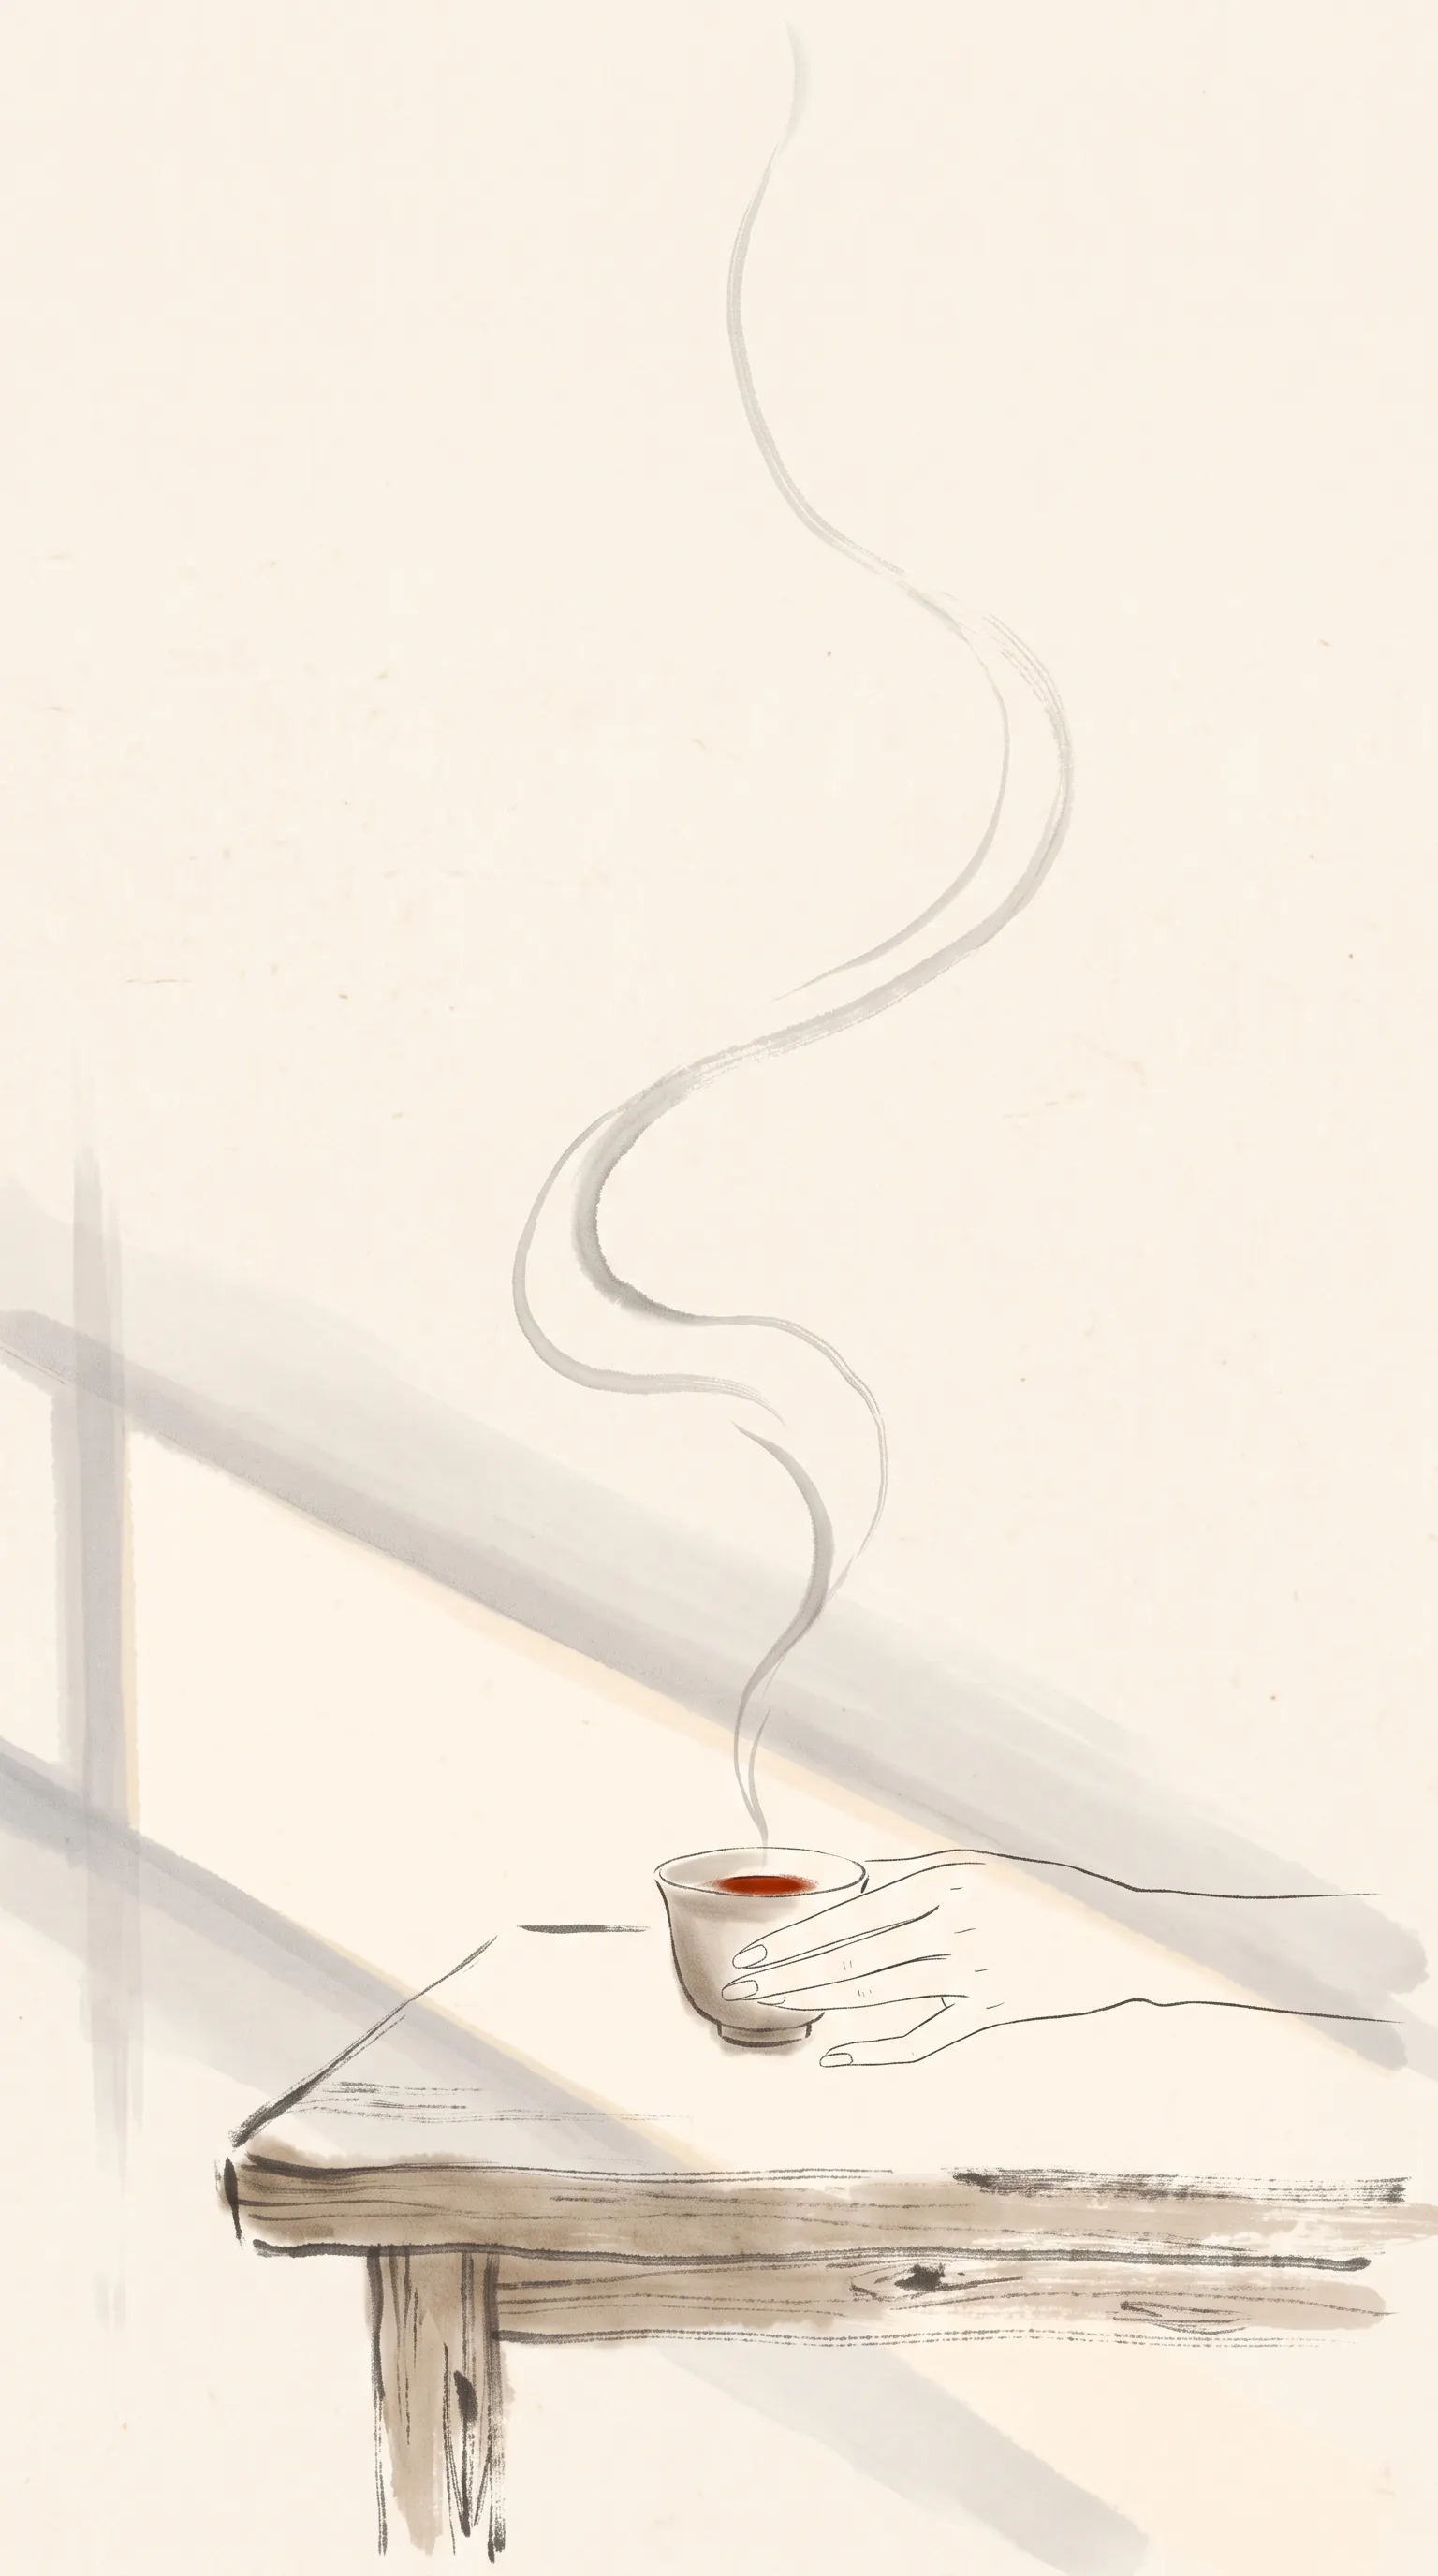
首帧
“The ribbon of steam rises and curls upward like a living, continuous wet brushstroke… The patch of sunlight slowly shifts.”
-
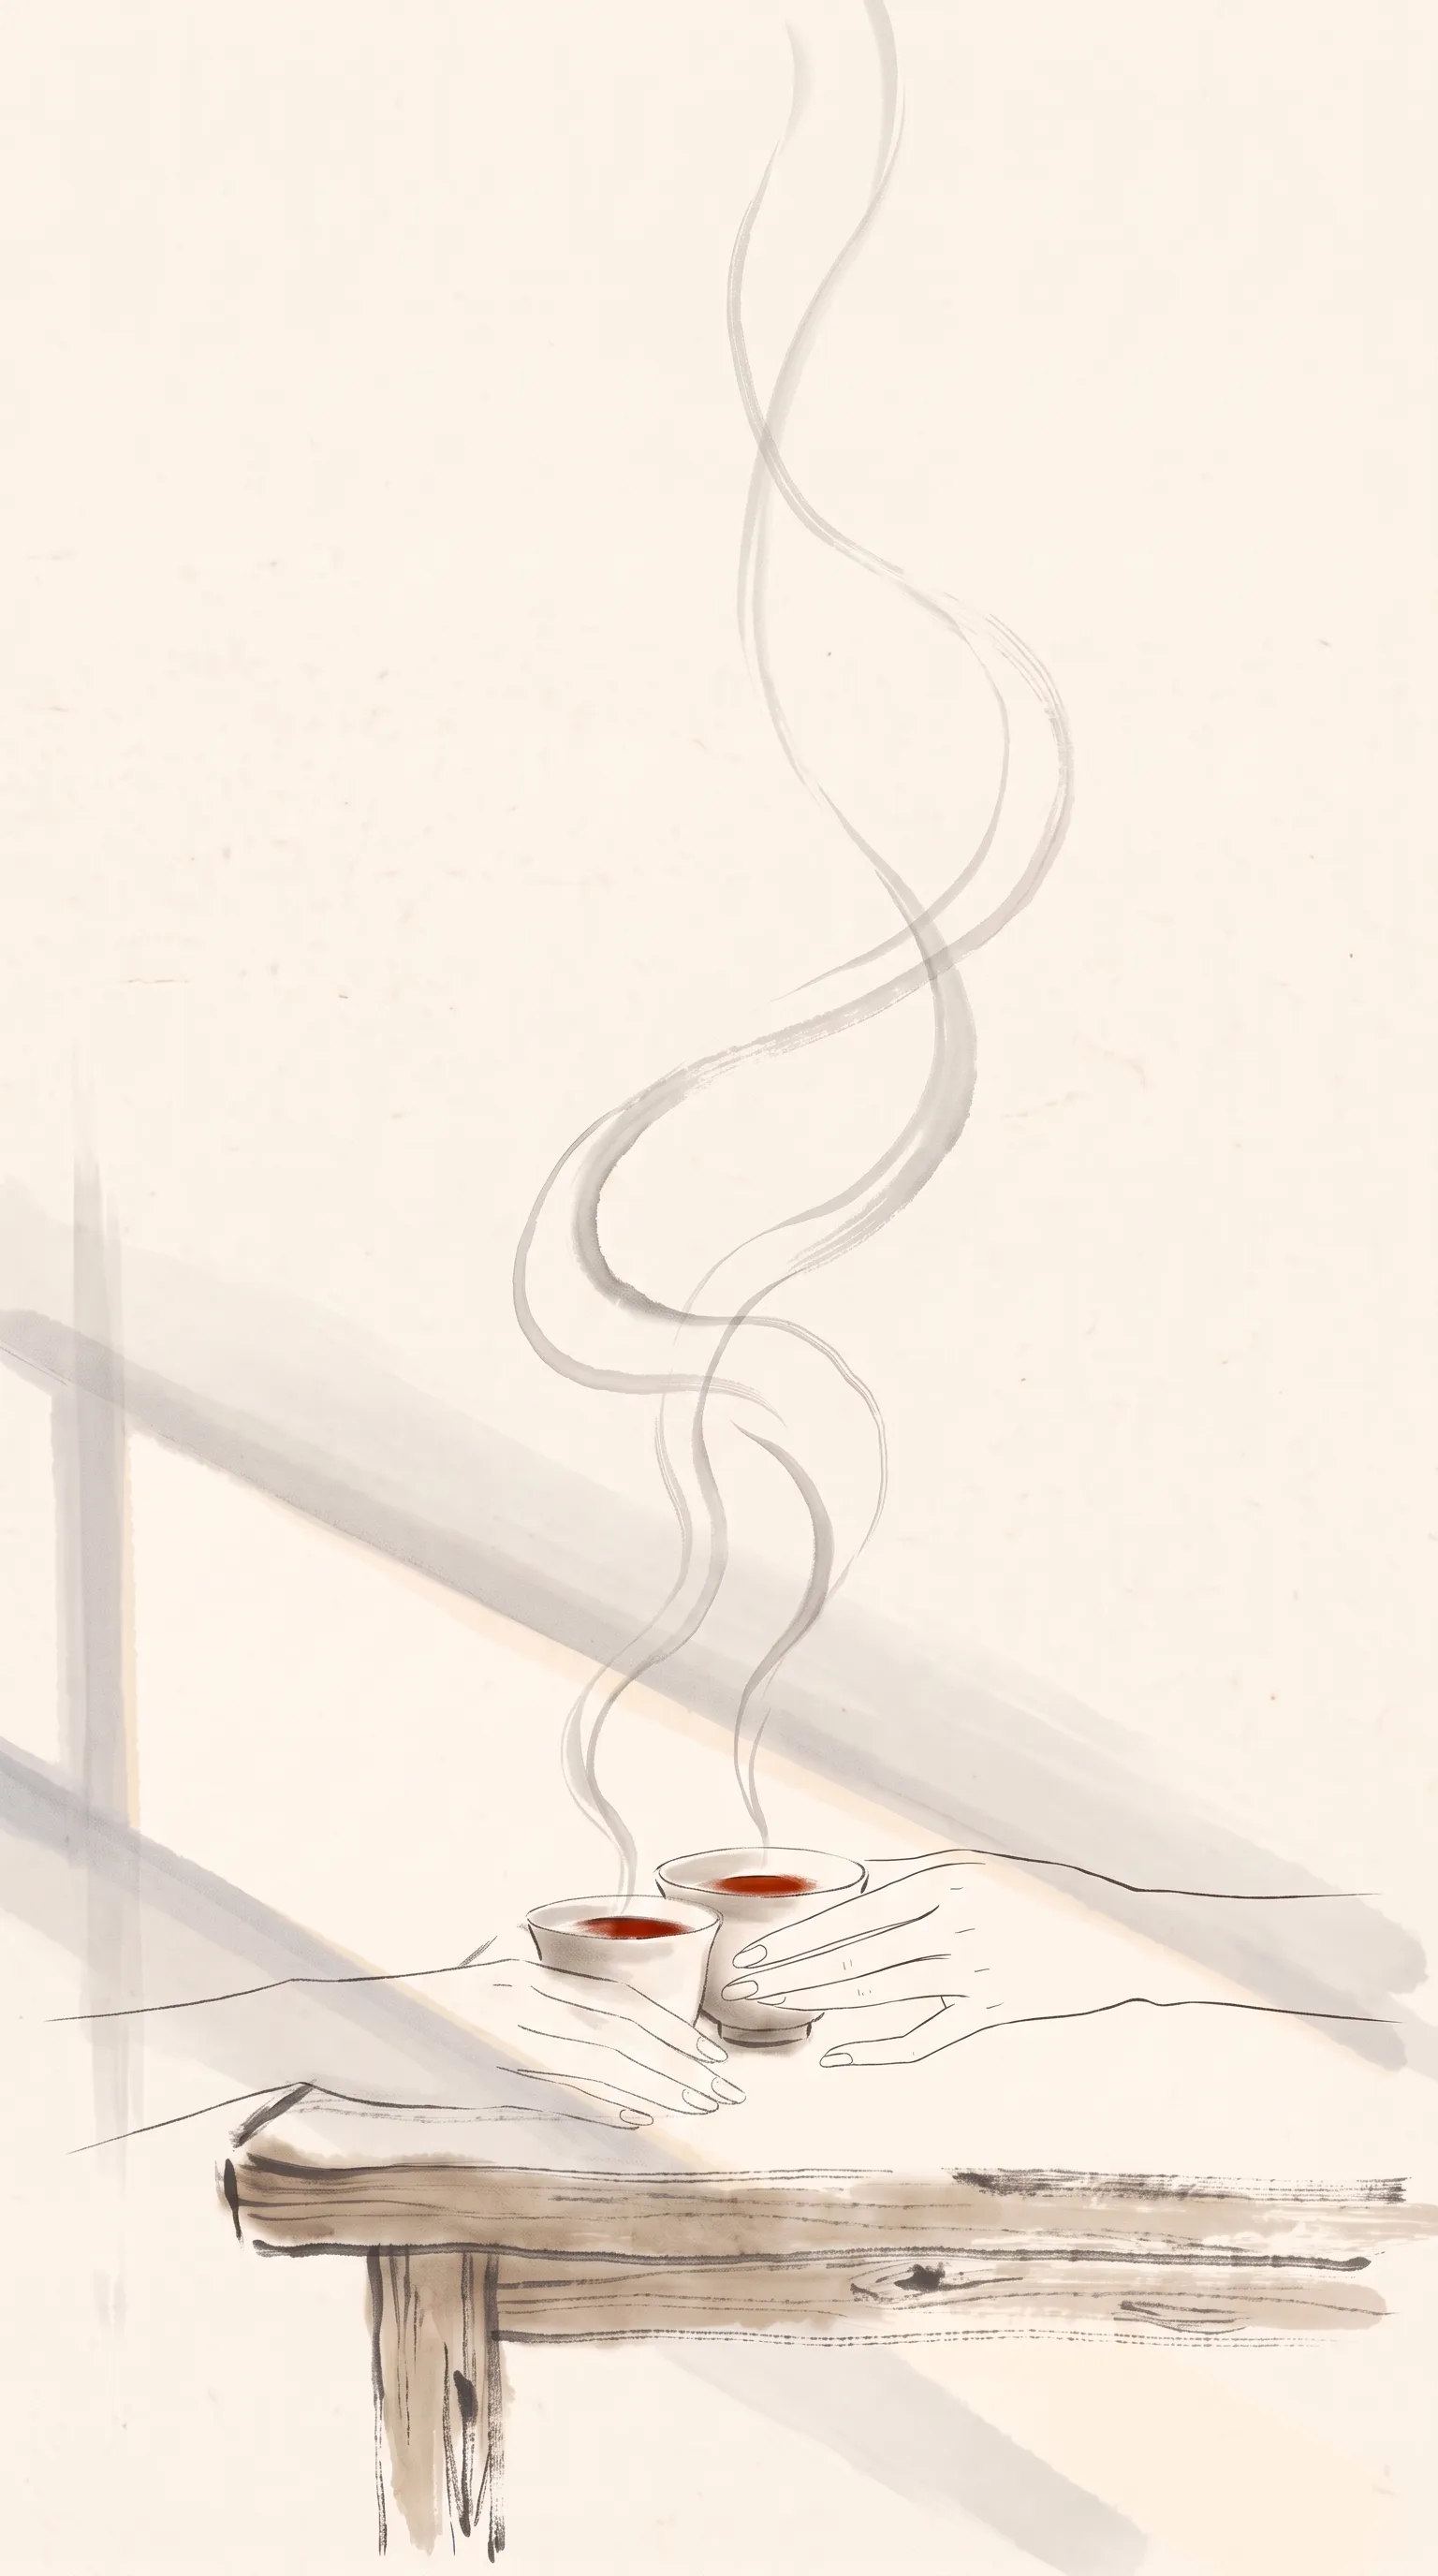
首帧
“The two hands move closer and their fingertips gently touch… The two ribbons of steam rise and slowly intertwine.”
-
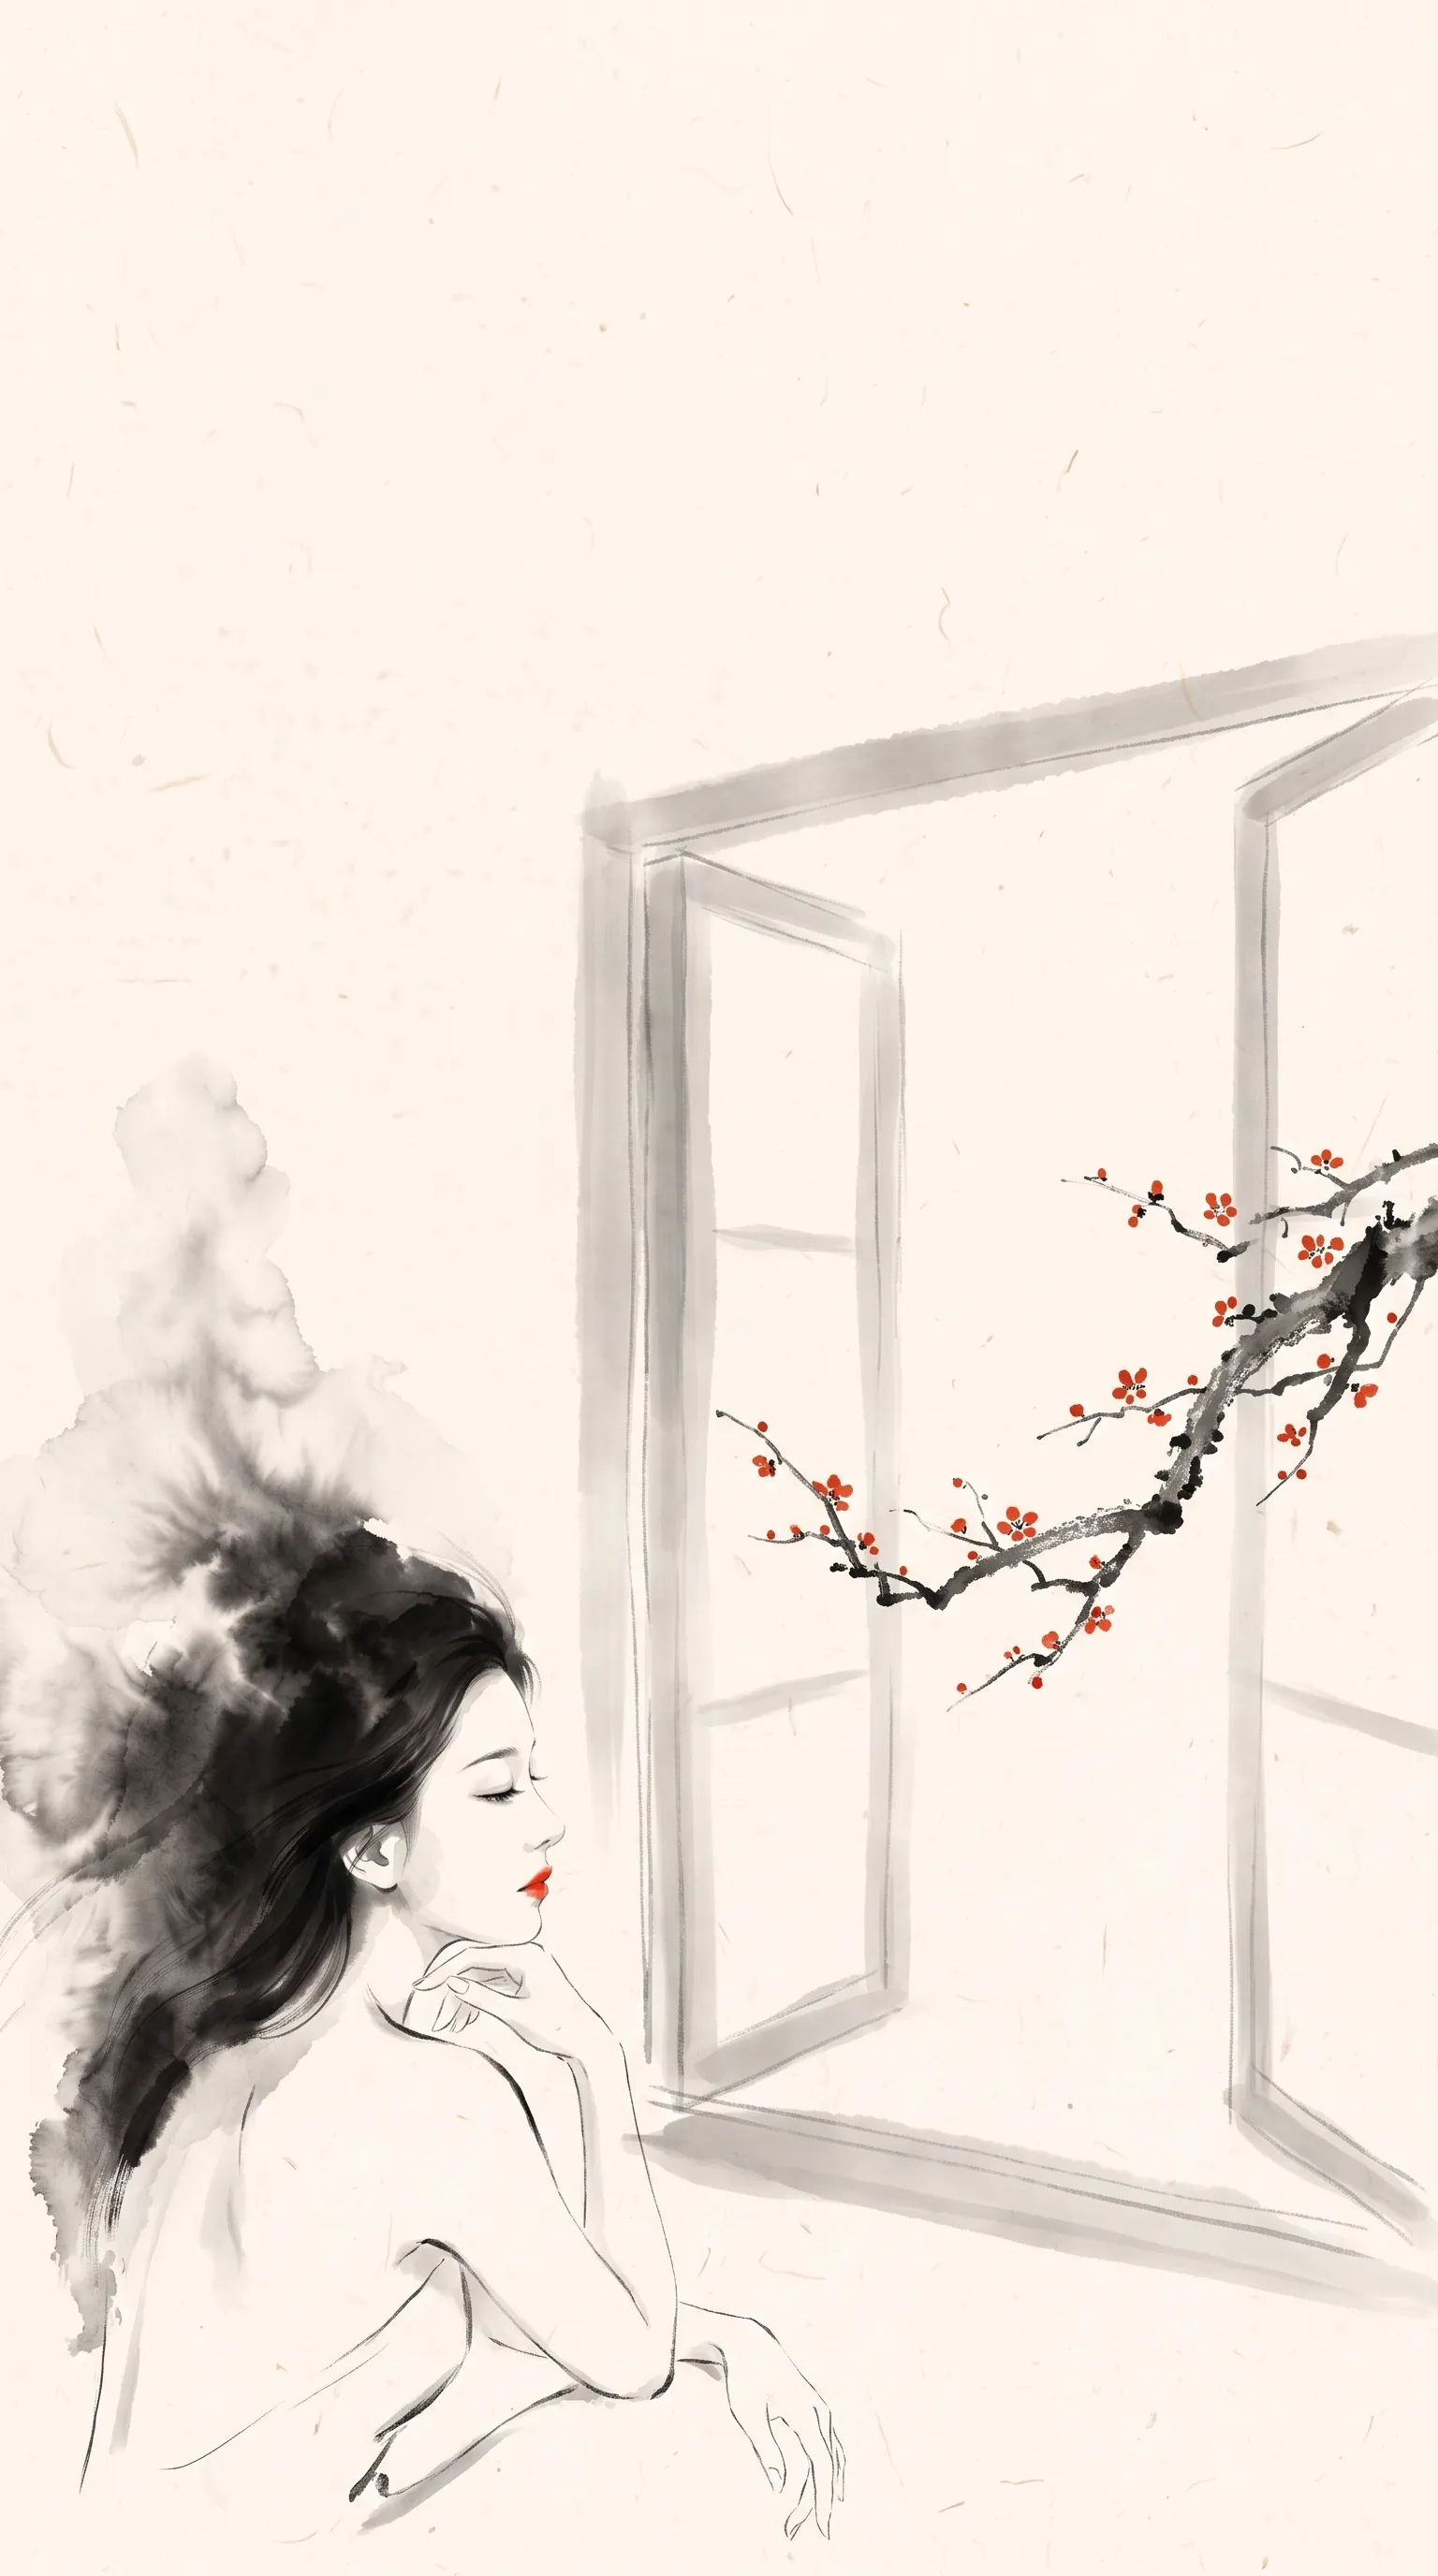
首帧
“A soft breeze moves the plum branch; a few vermilion petals detach and float slowly into the room.”
-
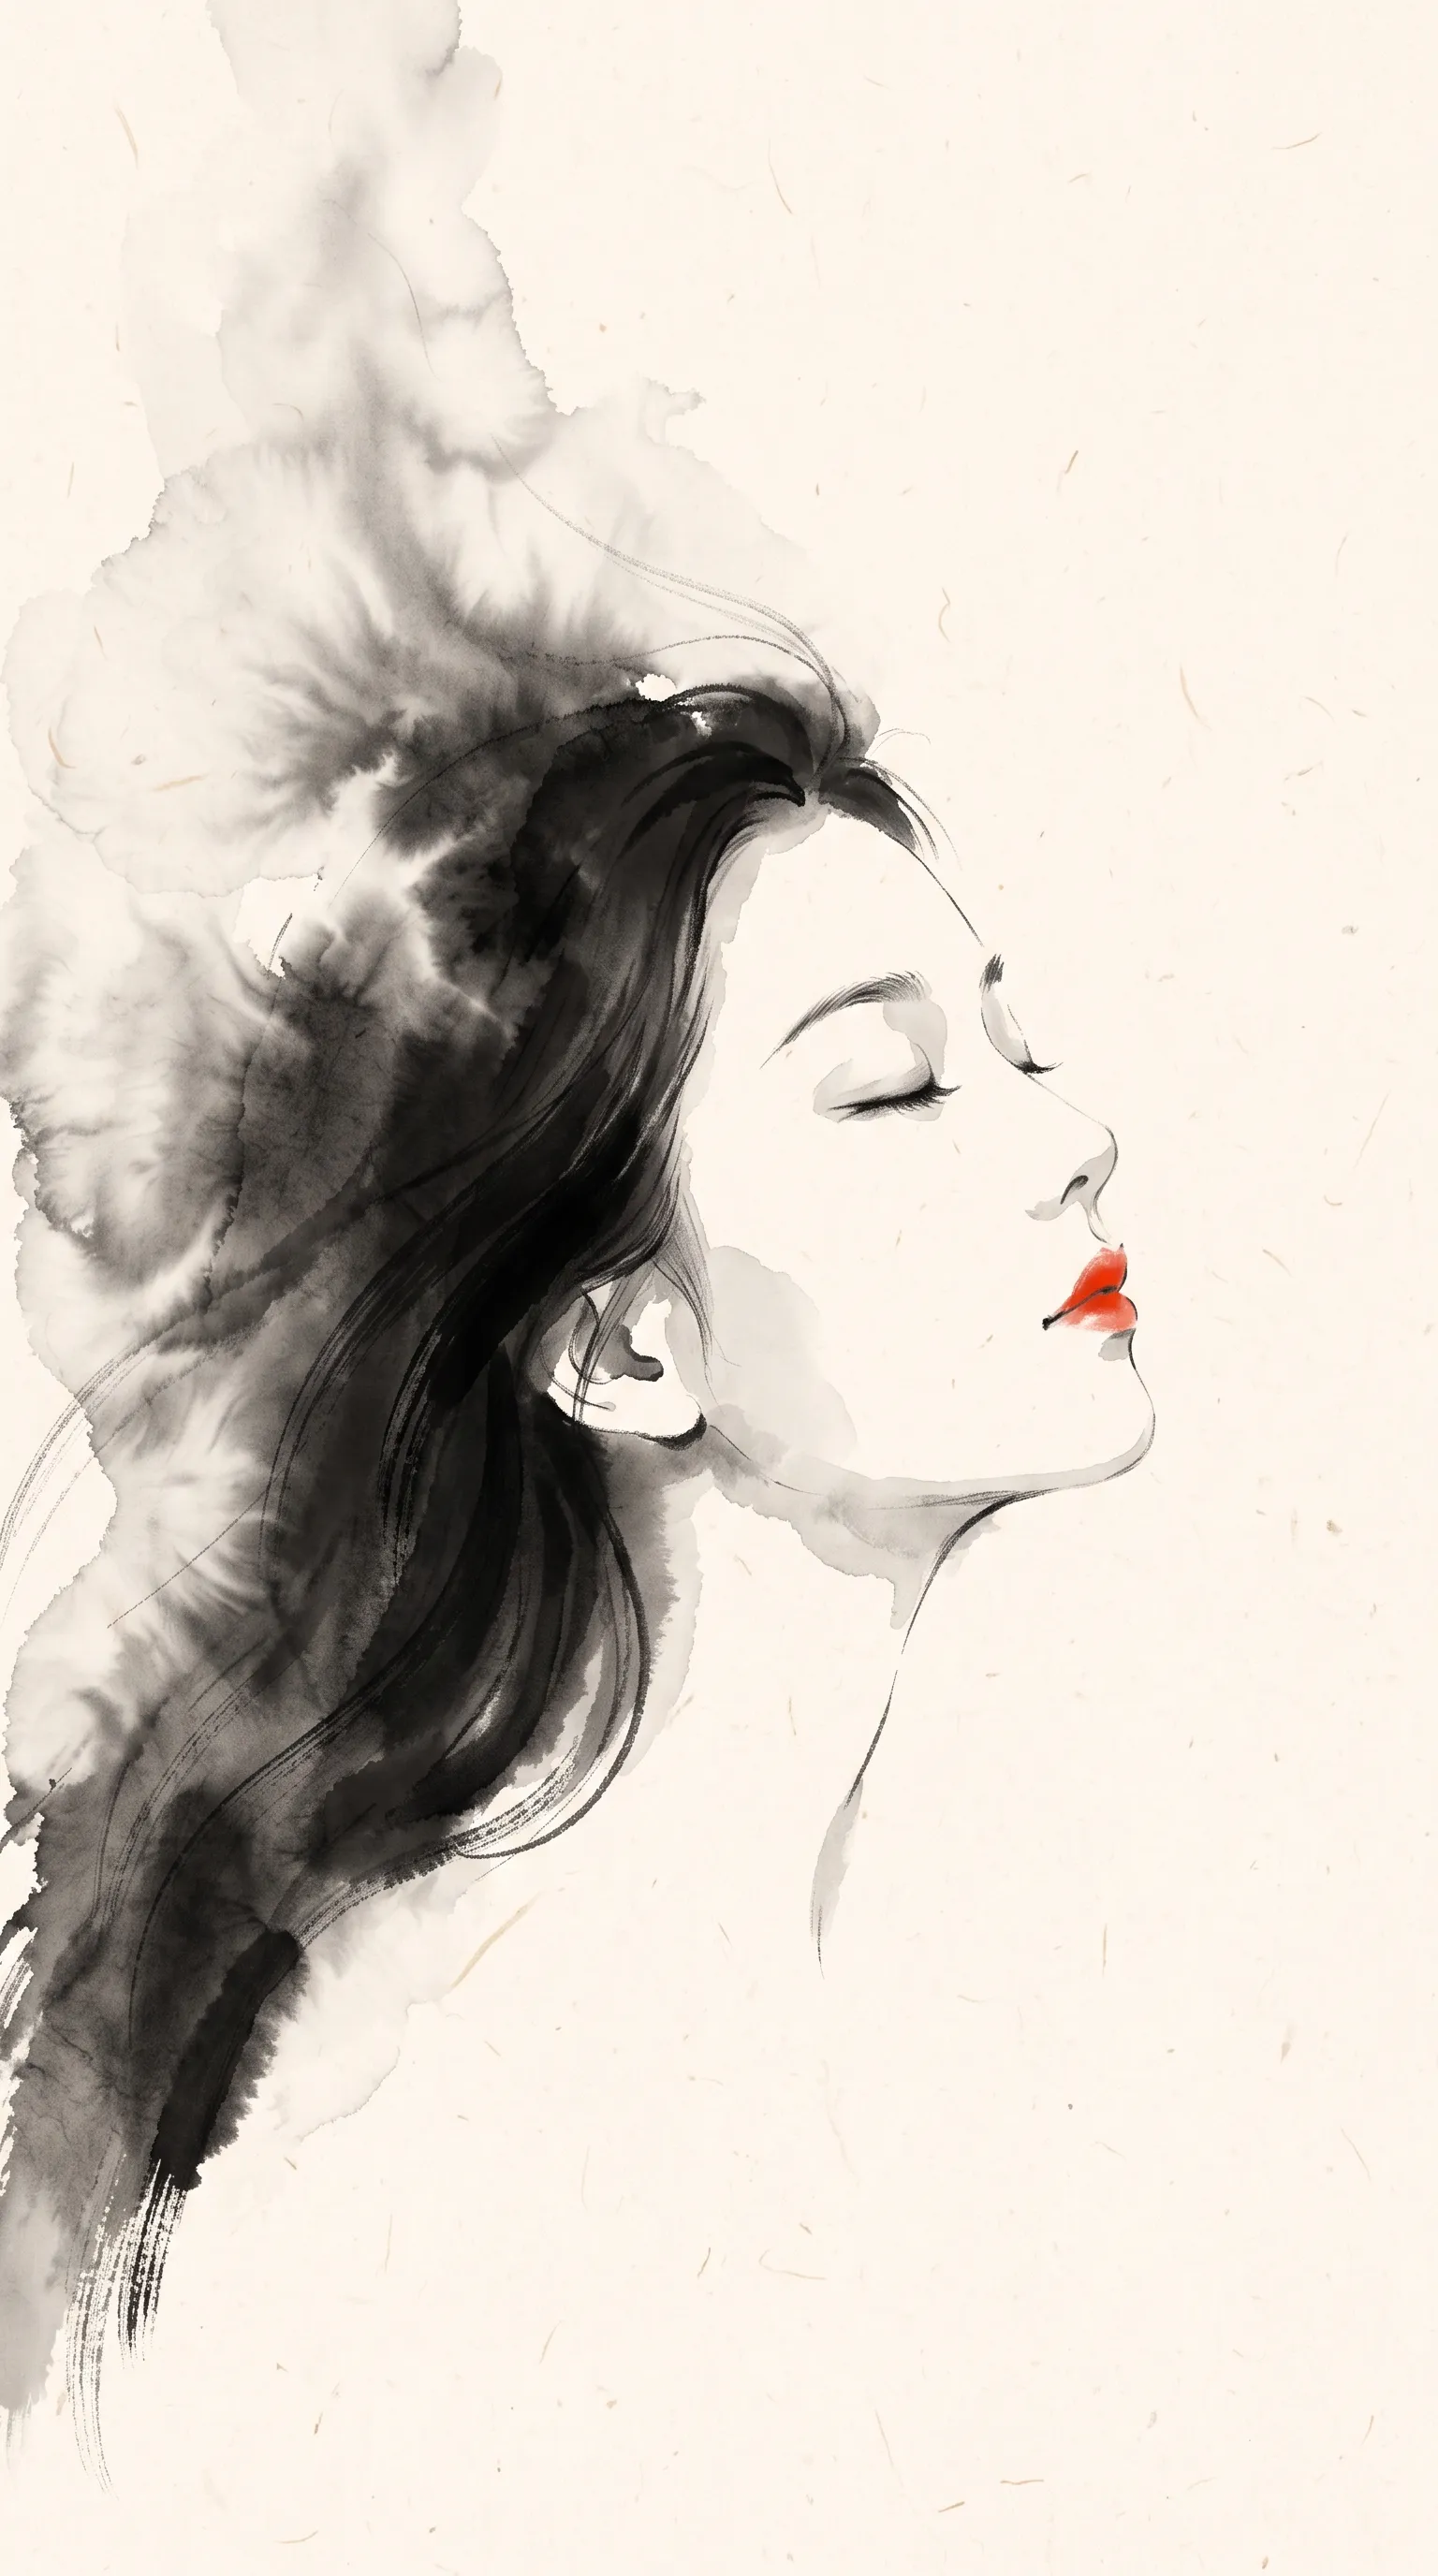
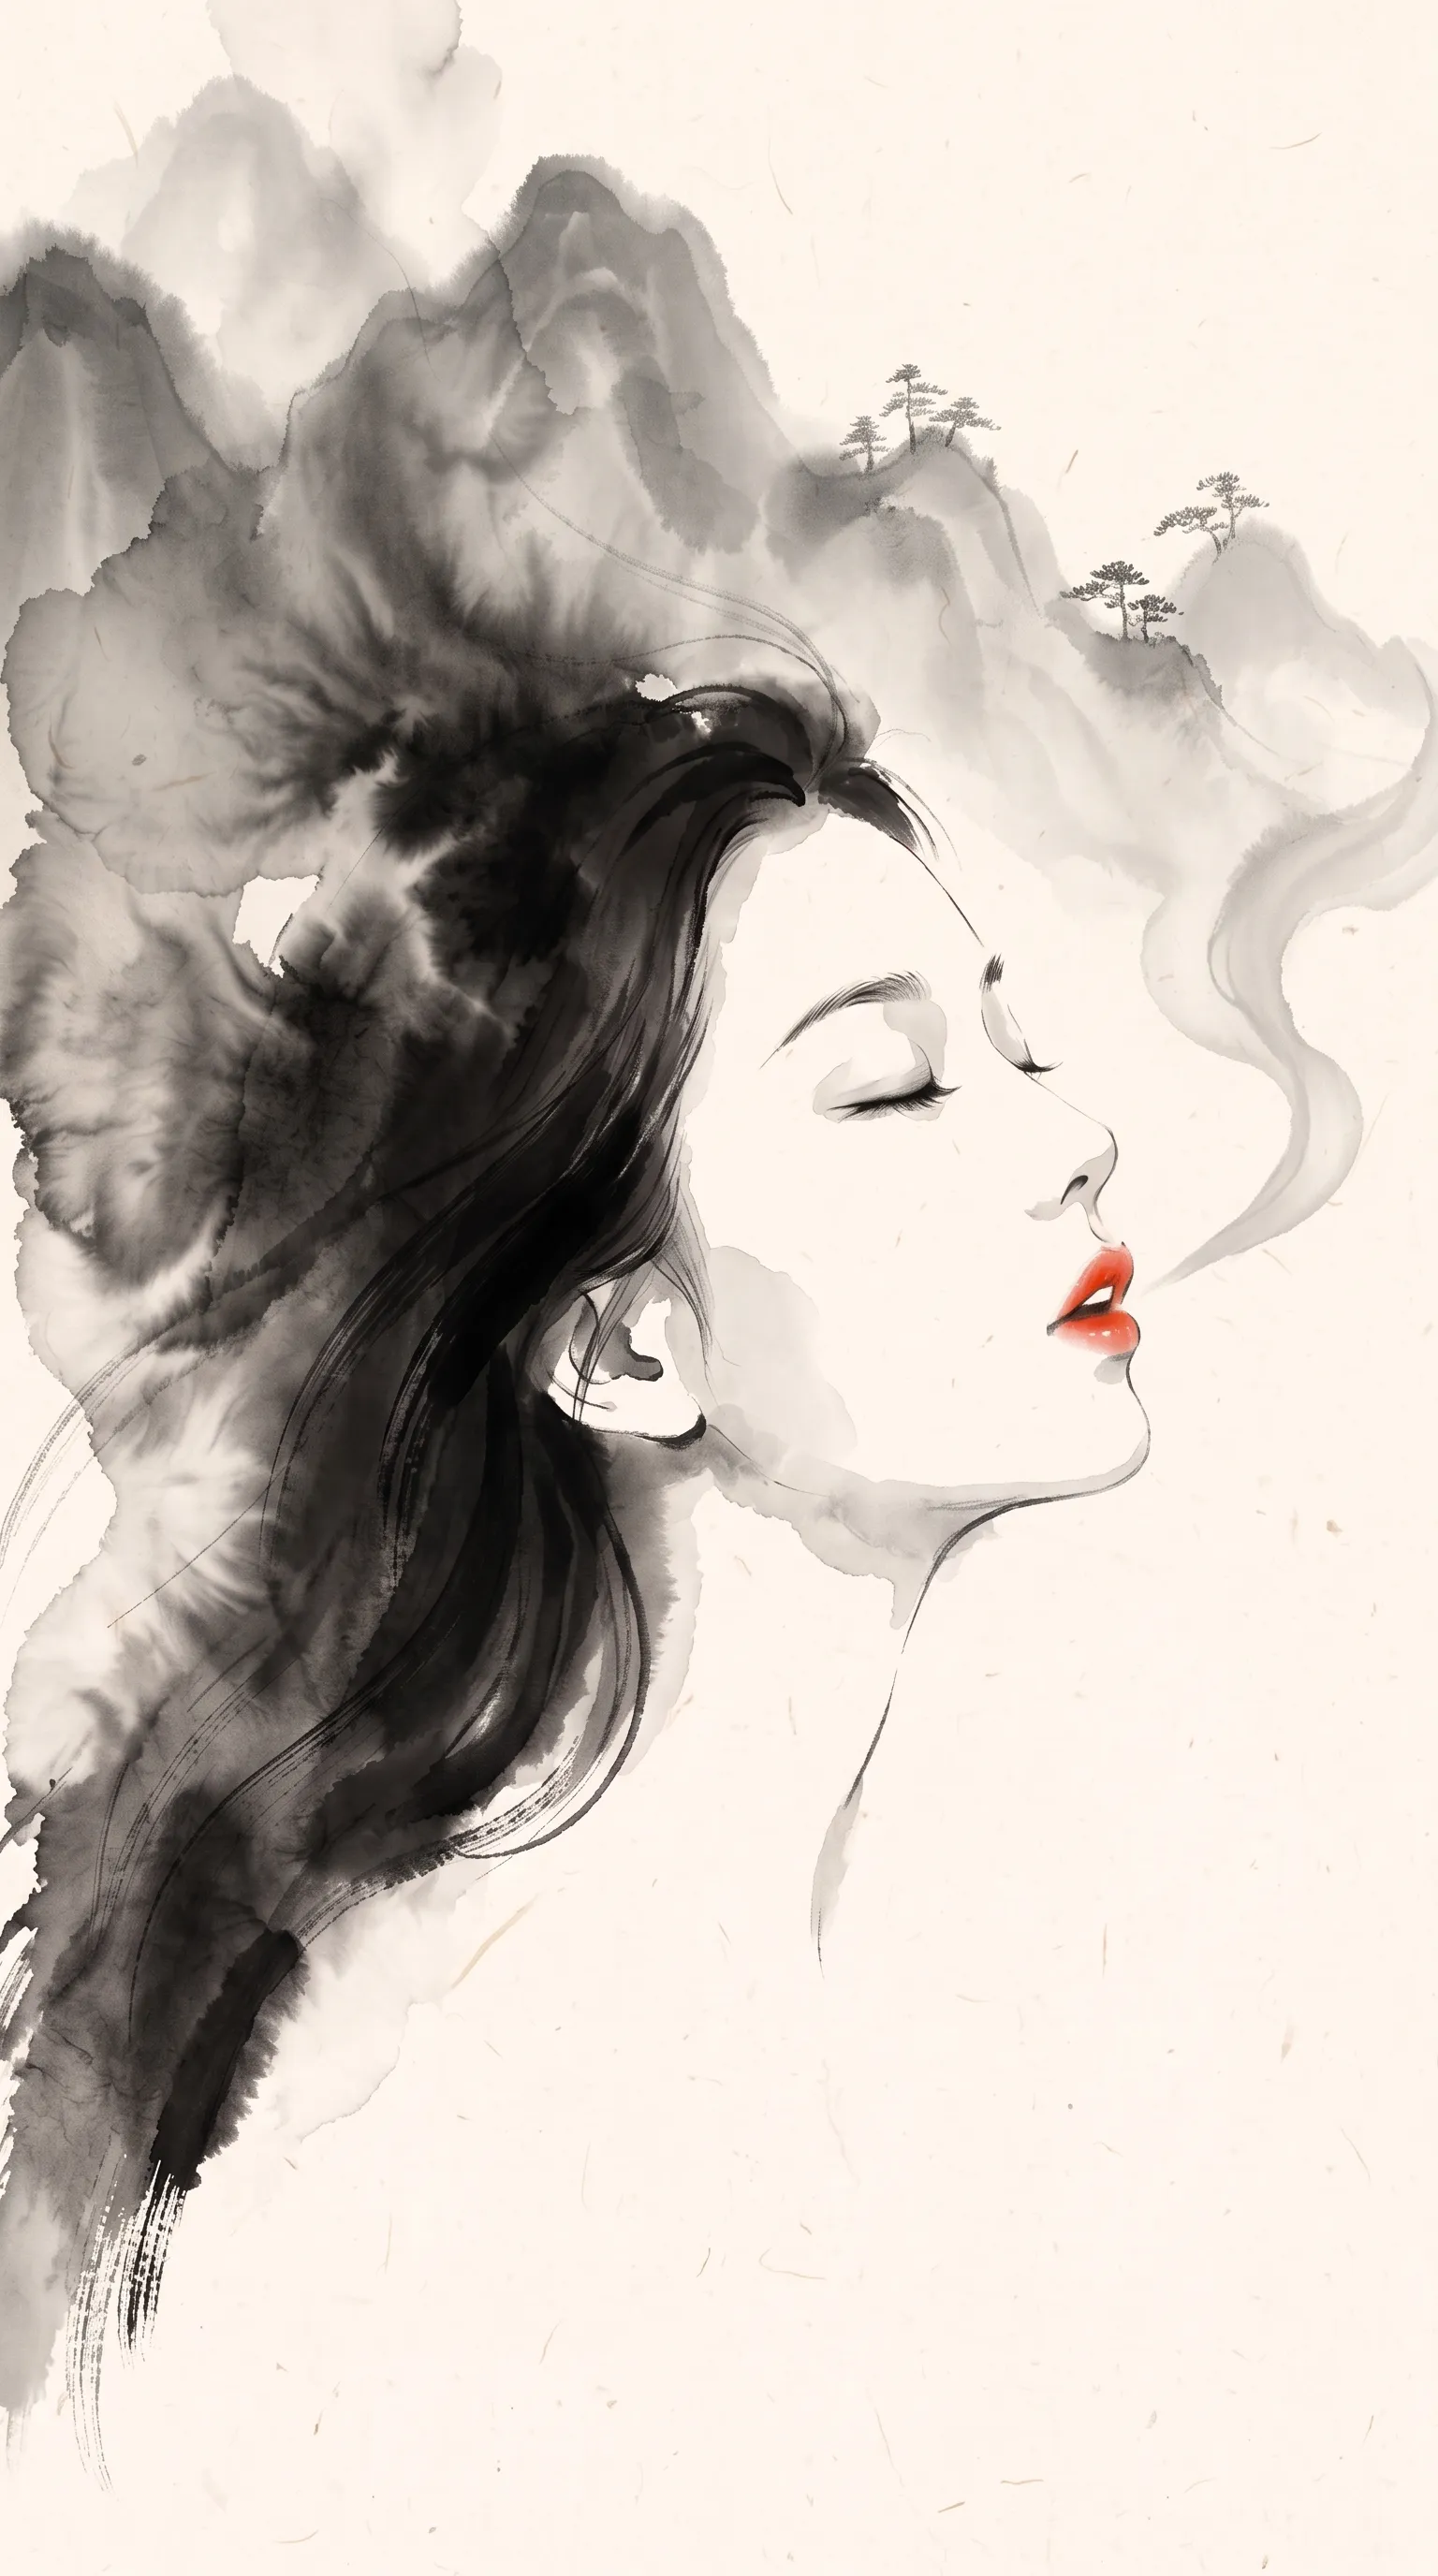
尾帧 首帧加尾帧
“Her vermilion lips softly part and she exhales… a long ribbon of pale grey ink mist… grows into a range of misty ink-wash mountains, matching the final frame.”
-
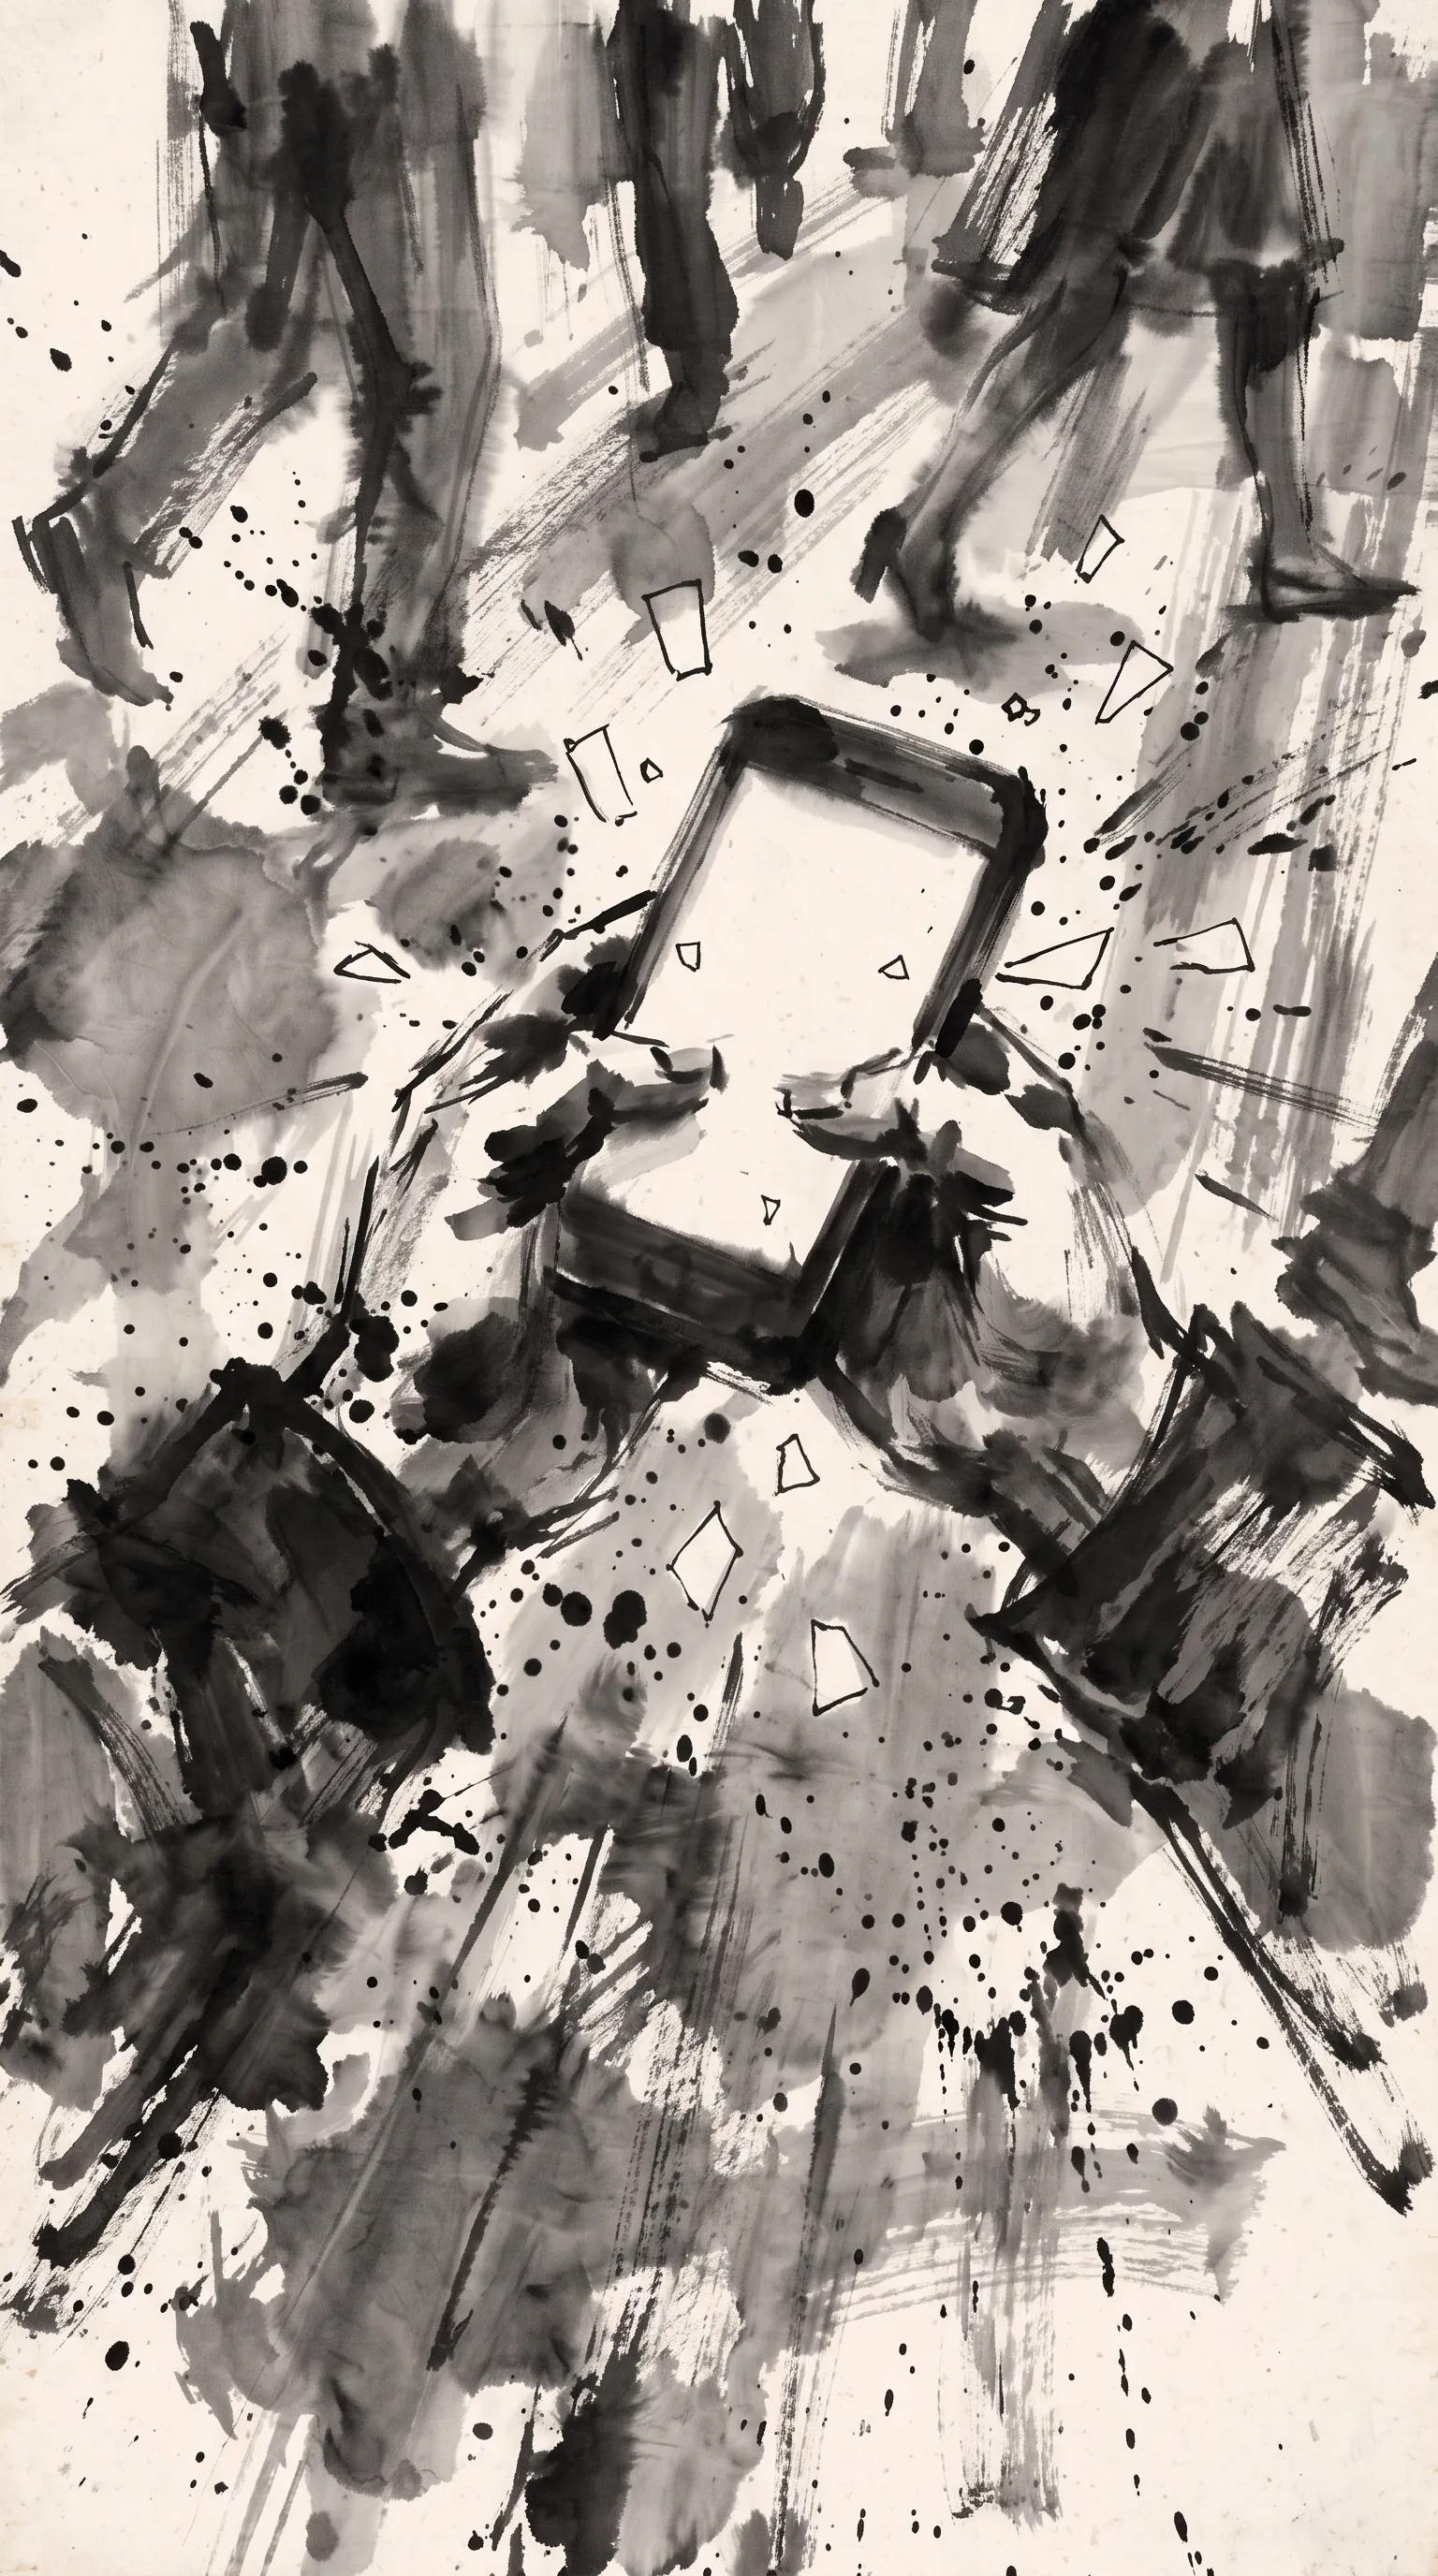
首帧
“Small blank paper message shapes keep popping out of the phone and flying past the camera; the blurred legs of other people hurry by.”
每条提示词都写明了机位(“one continuous shot with a very slow push-in”,一个非常缓慢推近的连续镜头)、哪几样东西在动以及怎么动,还有什么必须保持不变:宣纸上的水墨画,常常以朱红作为唯一的颜色。每条都要求无声,因为这个项目的声音是单独制作的:一段疏朗的古琴独奏和几个音效,一滴水声,毛笔划过宣纸的声音。
5. 分开处理环境声、音效和音乐
描述这个地点的声音,以及关键动作发出的可听见的声音。放下杯子、雨渐渐变小、脚步停下,不用配乐也能撑起一个节拍:在厨房场景里,杯子落下的那一声就出现在结尾之前。说明生成的场景里是否需要音乐,并避免“一段音乐性的持续低音,不要音乐”这类自相矛盾的要求。
在多个片段之间,把一段已确认的音乐作为独立的连续音轨,跨越剪切点,而不是要求每个片段重新生成同样的主题。保留有用的原生环境声和音效,需要时再单独重做个别声音。原生音轨是混好的:在提示词里分别要求各种声音,并不会给你分开的分轨。视频配乐与音效教程讲解了配乐和混音。
6. 怎么续接或编辑一个片段,而不改动其余部分?
先决定你要提的是下面三种请求中的哪一种,因为每一种保留的东西不同:
| 请求 | 保留什么 | 怎么请求 |
|---|---|---|
| 把这个片段当参考 | 人物、物体或动作(Google 的 Gemini Omni 页面,英文):说明是哪一项 | 以 <VIDEO_REF_0> 附上,并写明它的作用;它的声音会被忽略 |
| 修改这个片段 | 你点名的一切:表演、机位、节奏、空间关系、光线 | 只要求这一处修改,并列出必须保留的内容;重写整个场景会招来新的诠释 |
| 从它的结尾继续 | 从已确认的结尾出发的位置、运动方向、道具、光线和声音 | 从那个状态描述新的动作;不要把已经完成的段落重来一遍 |
附上之前,先剪出有用的片段:Google 的 API 用于修改或续接时最多接受 10 秒,用作参考时最多 3 秒。提交的片段会被完整使用,从第一帧到最后一帧,模型不会从一段长素材里自己挑一截。附上视频后,输出时长由 Omni 自己决定:续接部分为 3 到 10 秒。尾帧可以设定下一段的开场姿势,但不带动作和声音;视频两者都带,所以要检查结果是在延续它、重复它还是改变了它。在剪辑中,要让源片段和新素材能区分开,以免结尾播放两遍,并检查剪切处有没有迟疑、方向或声音的变化、环境声重置或音乐重新开始。
编辑之后,要在修改过的段落及其前后,把修订版和原版对比。修好了一个物体,并不能为一张变了的脸或一句变了的台词开脱。
7. 检查结果,修复真正的缺陷
在用它做任何后续之前,先看有用片段的动态效果,也听一听。检查要求的动作和谁说了什么、人物身份、出现或消失的物体、与地面的接触、碰撞、背景,以及你没要求的剪切。安静的特写和奔跑的角色需要关注的地方不一样。
然后找到缺陷,选择能保留好内容的最小修复:问题出在剪辑上时,修剪、换一条或移动剪切点。当画面没问题但某句台词不行时,就用选好的声音重新录这句台词,并把它对齐到画面上。只有当人物身份、调度或动作坏到无法保留时,才替换整个镜头。
有一个限制要知道:Google 的安全过滤器(因地区而异)会同时检查提示词和生成的视频,并屏蔽违反使用政策的提示词。改变构图、尺寸或时长都无法解决这类拒绝,所以不要把它当成技术故障去重试:保留已经成功的镜头,为那一个镜头换一种做法。